Antes de cambiar de modelo de IA, evalúalo con casos de tu negocio
Guía práctica para comparar dos modelos con el mismo prompt, errores visibles y un evaluador local en Node.js. Incluye datos ficticios señalados y código probado.
Başlıklar
Vas a cambiar el modelo que clasifica mensajes de clientes porque uno nuevo promete mejores resultados o menor costo. Una demo con dos mensajes sale bien; en producción, sin embargo, los reembolsos terminan en ventas y el spam llega a soporte. La comparación útil no es cuál responde más bonito, sino cuál acierta en tus casos y qué errores estás dispuesto a aceptar. Puedes empezar con una evaluación pequeña, local y sin pagar una plataforma adicional.
Primero define la decisión, luego la prueba
Usaremos un clasificador ilustrativo de mensajes entrantes con tres destinos: ventas, soporte y spam. El objetivo no es demostrar que un modelo real funciona: los seis mensajes de abajo son ficticios y sus respuestas están escritas como ejemplo para probar el método. En tu producto debes reemplazarlos por mensajes representativos, anonimizados cuando contengan datos personales, y registrar la respuesta real de cada modelo.
La guía oficial de buenas prácticas de evaluaciones de OpenAI recomienda pruebas específicas de la tarea, casos cercanos a producción y revisión humana de los criterios. También advierte contra decidir por impresión subjetiva. No necesitas adoptar una API de evaluación para aplicar esa idea. De hecho, la documentación actual de Evals indica que esa plataforma está en proceso de retirada y orienta a usuarios nuevos hacia Datasets; por eso aquí usamos un archivo local, independiente de un proveedor.
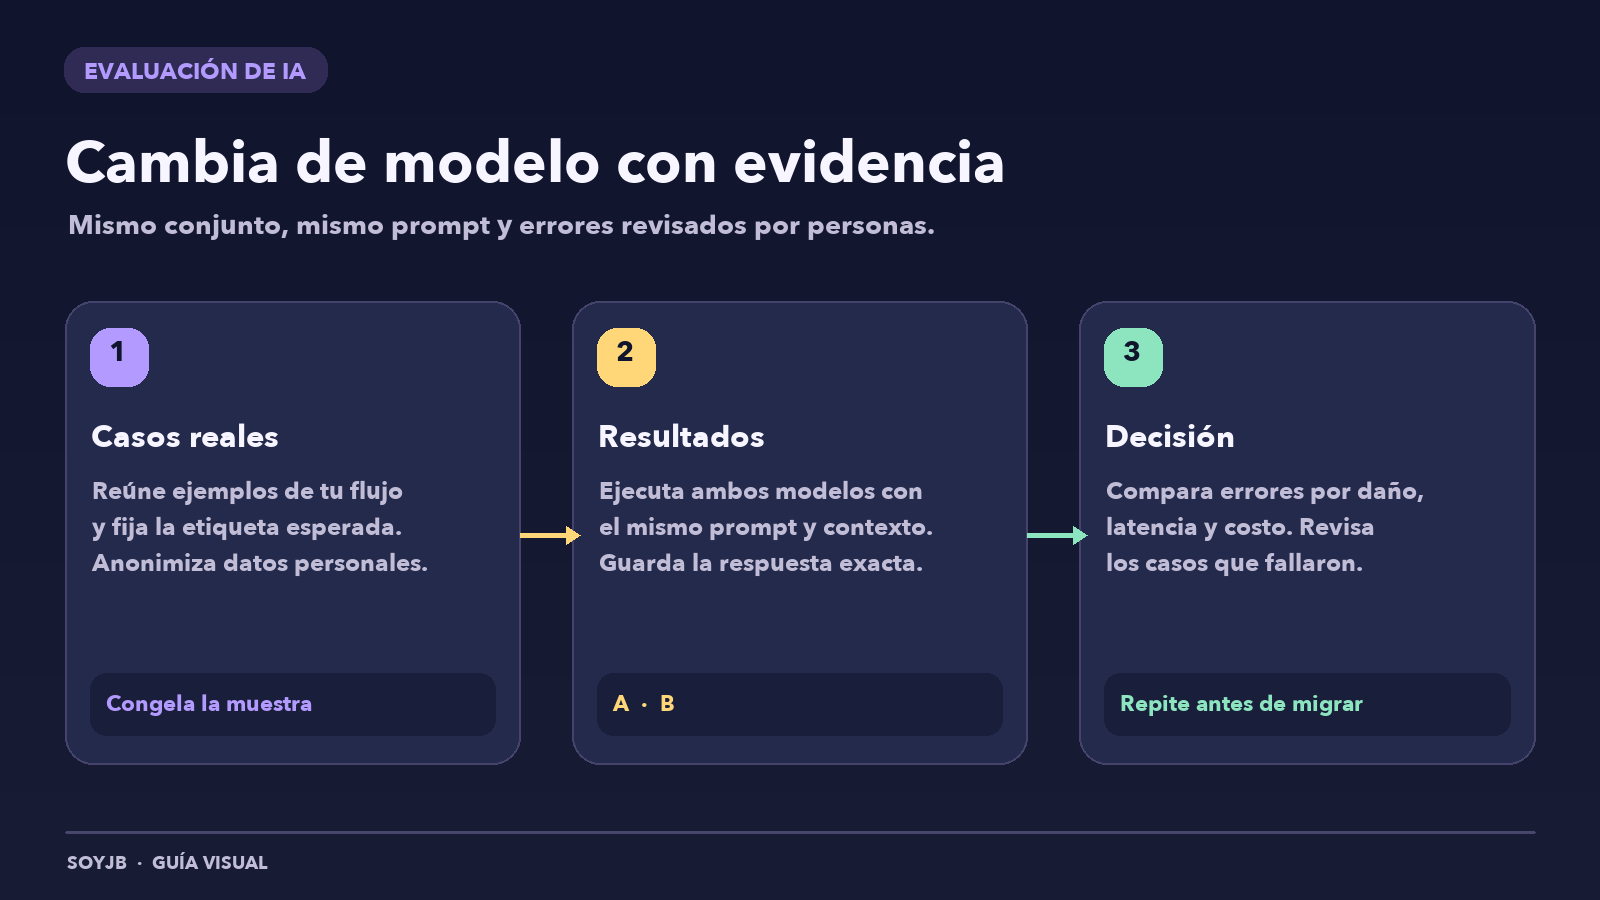
La comparación debe repetir los mismos casos y el mismo prompt; revisa el daño de cada error antes de migrar.
Crea un conjunto de casos que pueda fallar
Empieza con 20 o 30 mensajes reales revisados por alguien que conozca el proceso. Si aún no tienes tráfico, escribe ejemplos explícitamente sintéticos y no presentes la puntuación como rendimiento de producción. Incluye preguntas fáciles y fronteras difíciles: cancelar y pedir reembolso puede parecer una consulta comercial, pero en este flujo pertenece a soporte; una oferta de enlaces puede contener palabras de ventas y seguir siendo spam.
Para cada fila guarda el texto de entrada, la etiqueta esperada y las salidas de los modelos que comparas. Congela el conjunto antes de ajustar el prompt. Si cambias los ejemplos cada vez que ves un error, terminarás midiendo cuánto recuerdas de la prueba, no si el sistema mejora. Separa unos casos nuevos para una comprobación posterior.
Usa el mismo prompt y registra respuestas reales
Pega este prompt en cada modelo con idéntico texto de entrada. Sustituye [MENSAJE] por cada mensaje de tu conjunto y anota exactamente lo que devolvió, incluso si no siguió el formato:
Clasifica el mensaje de un cliente en una sola etiqueta: ventas, soporte o spam.
Ventas: preguntas para comprar, contratar o facturar.
Soporte: acceso, problemas, cancelación o reembolso de una cuenta existente.
Spam: promoción no solicitada o enlaces ajenos al servicio.
Devuelve únicamente la etiqueta en minúsculas, sin explicación.

Mensaje: [MENSAJE]
Si el sistema real dispone de contexto adicional —por ejemplo, si el remitente ya es cliente—, añádelo igual para todos los candidatos. Si necesitas salida JSON o llamadas a herramientas, prueba ese formato real en lugar de simplificarlo solo para obtener una puntuación mejor.
Cuenta errores y mira cuáles son
Guarda este código como evaluar-clasificador.js y ejecútalo con node evaluar-clasificador.js. No requiere paquetes. Sustituye los valores a y b por las respuestas observadas de cada modelo. El código solo evalúa las etiquetas: no llama a ningún modelo.
// Datos ficticios para comprobar el método, no resultados de modelos reales.
const casos = [
  { texto: '¿Cuánto cuesta el plan para 15 personas?', esperado: 'ventas', a: 'ventas', b: 'ventas' },
  { texto: 'No puedo entrar a mi cuenta', esperado: 'soporte', a: 'soporte', b: 'soporte' },
  { texto: 'Duplica tus ingresos con este enlace', esperado: 'spam', a: 'spam', b: 'spam' },
  { texto: 'Quiero cancelar y pedir reembolso', esperado: 'soporte', a: 'ventas', b: 'soporte' },
  { texto: '¿Tienen factura para empresas?', esperado: 'ventas', a: 'ventas', b: 'ventas' },
  { texto: 'Oferta de enlaces para posicionamiento', esperado: 'spam', a: 'ventas', b: 'soporte' },
];

const etiquetas = new Set(['ventas', 'soporte', 'spam']);

function evaluar(columna) {
  const errores = [];
  let aciertos = 0;
  for (const [indice, caso] of casos.entries()) {
    const respuesta = String(caso[columna] ?? '').trim().toLowerCase();
    if (respuesta === caso.esperado && etiquetas.has(respuesta)) {
      aciertos++;
    } else {
      errores.push({ caso: indice + 1, esperado: caso.esperado, respuesta });
    }
  }
  return { columna, aciertos, total: casos.length, errores };
}

console.log(JSON.stringify([evaluar('a'), evaluar('b')], null, 2));
Con las respuestas ficticias incluidas, la columna A acierta cuatro de seis y B cinco de seis. Ese número no dice que B sea mejor en tu negocio: ambos fallan en un caso de spam y seis filas son demasiado pocas para estimar fiabilidad. El campo errores muestra el número de caso, la etiqueta esperada y la respuesta recibida. Revisa esas filas una por una antes de cambiar un modelo o prompt.
Decide con una regla útil, no con un porcentaje bonito
Para este flujo podrías exigir cero casos de spam enviados a ventas en el conjunto de validación, al menos 95 % de aciertos en soporte y revisión humana de todas las cancelaciones. Esos umbrales son ejemplos de política, no garantías estadísticas; elige los tuyos según el daño de cada error. Mide también latencia y costo con la misma carga, porque un modelo ligeramente más preciso puede resultar inviable si retrasa la respuesta o multiplica el gasto.
Cuando amplíes el conjunto, registra fecha, versión del prompt, versión del modelo, casos nuevos y errores corregidos. Vuelve a ejecutarlo antes de cada cambio. La documentación oficial sobre evaluación de agentes añade trazas y evaluadores para flujos con herramientas: si tu sistema consulta CRM, envía correos o cambia datos, evalúa también qué hizo, no solo el texto final. La primera ganancia es sencilla: pasar de “me parece mejor” a una decisión que otro miembro del equipo puede reproducir y cuestionar.
Recibe lo nuevo en tu correo
Workshops gratis, herramientas y novedades de IA aplicadas a negocio, sin humo.