Automatiza la revisión de enlaces internos antes de perder lectores
Un auditor en Python para detectar enlaces internos que fallan en tus artículos. Código probado, límites claros y un prompt para revisar sin inventar fuentes.
Başlıklar
Una guía puede estar bien escrita y perder utilidad por un enlace que termina en 404. Nos pasó al revisar un artículo de SoyJB sobre NotebookLM y Claude Code: tres referencias ya no cargaban. Corregirlas en la URL existente fue más valioso para el lector que producir otra nota parecida. Este pequeño auditor automatiza una parte del control: encuentra enlaces internos en un artículo publicado y marca los que fallan.
Qué hace y qué deja para una persona
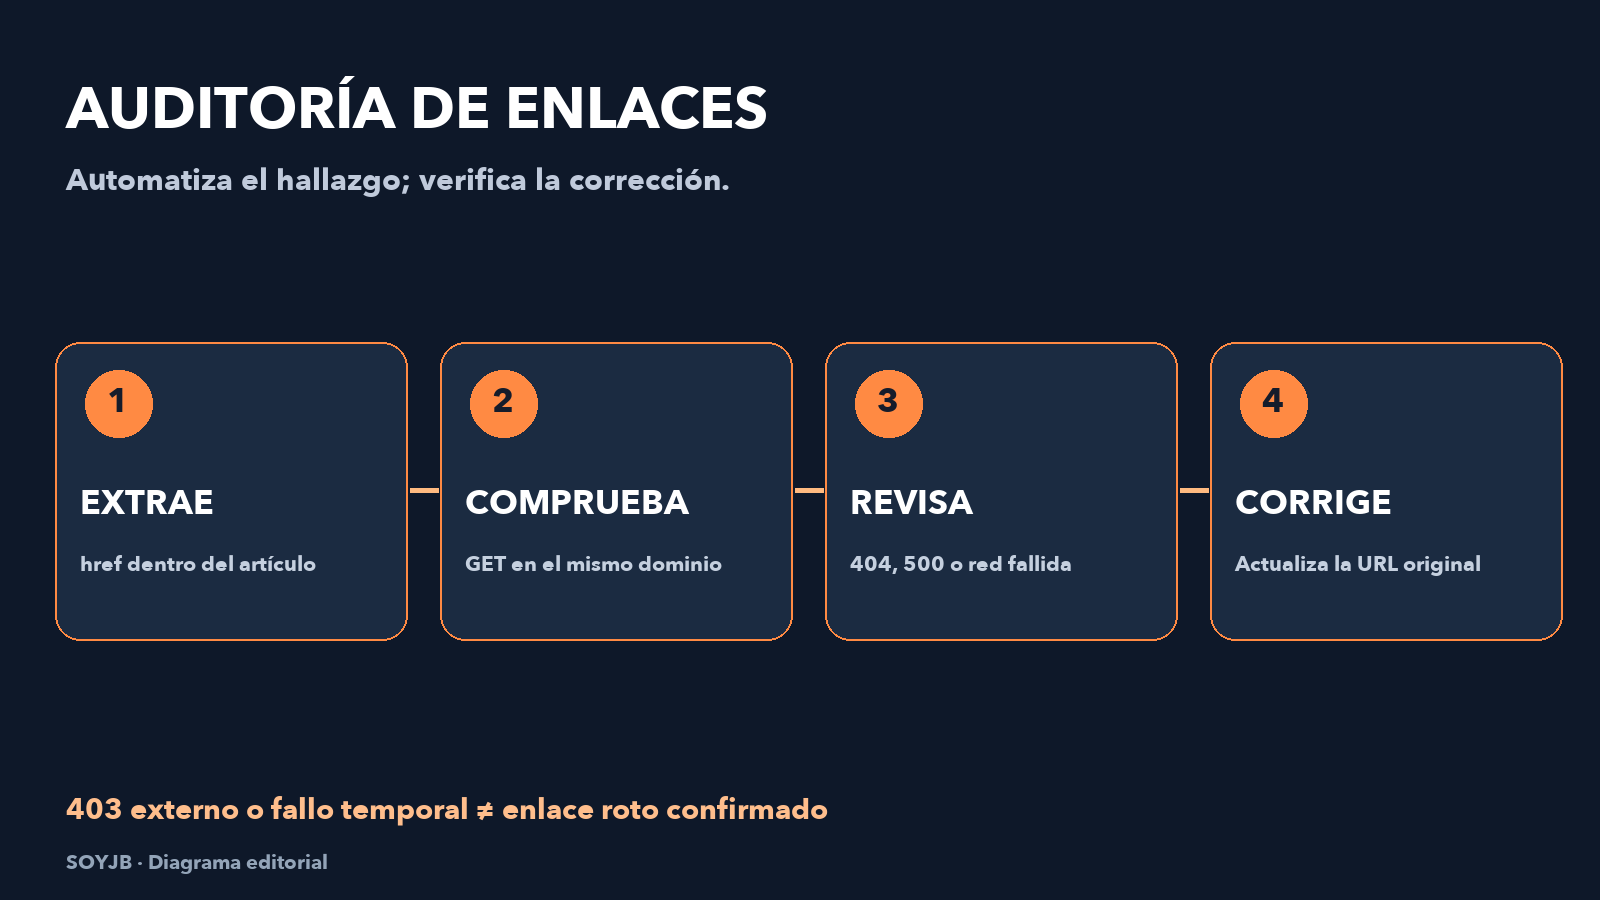
El script descarga una página, lee enlaces <a href> dentro de <article>, convierte rutas relativas en URLs completas, elimina fragmentos y comprueba hasta 50 enlaces del mismo dominio. Usa solicitudes GET porque algunos servidores responden distinto a HEAD. Reporta HTTP 4xx/5xx o errores de conexión, pero no edita ni borra nada. Un error transitorio no prueba que el enlace esté roto: ábrelo antes de modificar la página.
Google recomienda usar enlaces HTML rastreables con href para que pueda descubrir páginas, según su guía oficial de enlaces. Eso no convierte cada 404 en una penalización automática. El beneficio directo de la auditoría es que el lector llegue al recurso prometido.
Script copiable
Guarda este archivo como auditar_enlaces.py. Usa solo la biblioteca estándar de Python. Cambia la URL del ejemplo por la de una publicación propia. Ejecuta el auditor de forma periódica sobre tus artículos importantes; si tu CMS expone un catálogo, genera la lista de URLs desde allí.
from html.parser import HTMLParser
from urllib.error import HTTPError, URLError
from urllib.parse import urljoin, urlparse, urldefrag
from urllib.request import Request, urlopen
import sys

class Links(HTMLParser):
    def __init__(self):
        super().__init__()
        self.hrefs = []
        self.article_depth = 0

    def handle_starttag(self, tag, attrs):
        if tag == 'article':
            self.article_depth += 1
        if tag == 'a' and self.article_depth:
            href = dict(attrs).get('href')
            if href:
                self.hrefs.append(href)

    def handle_endtag(self, tag):
        if tag == 'article' and self.article_depth:
            self.article_depth -= 1

def fetch(url):
    req = Request(url, headers={'User-Agent': 'SoyJB-Link-Audit/1.0'})
    with urlopen(req, timeout=10) as response:
        return response.read().decode('utf-8', errors='replace')

def internal_links(html, page):
    parser = Links()
    parser.feed(html)
    host = urlparse(page).hostname
    urls = set()
    for href in parser.hrefs:
        absolute, _ = urldefrag(urljoin(page, href))
        parsed = urlparse(absolute)
        if parsed.scheme in ('http', 'https') and parsed.hostname == host:
            urls.add(absolute)
    return sorted(urls)

if __name__ == '__main__':
    page = sys.argv[1]
    try:
        links = internal_links(fetch(page), page)
    except (HTTPError, URLError, TimeoutError) as exc:
        raise SystemExit(f'No se pudo leer el artículo: {exc}')
    errors = []
    for url in links[:50]:
        try:
            fetch(url)
            print('OK ', url)
        except HTTPError as exc:
            if exc.code >= 400:
                errors.append((url, str(exc.code)))
        except (URLError, TimeoutError) as exc:
            errors.append((url, str(exc)))
    for url, reason in errors:
        print('REVISAR', reason, url)
    print(f'{len(links[:50])} enlaces internos comprobados; {len(errors)} para revisar')
Ejemplo de ejecución: python3 auditar_enlaces.py https://soyjb.com/blog/claude-code-con-notebook-lm. Lo probamos el 13 de octubre: detectó un enlace interno comprobable, respondió OK y no marcó errores. También probamos el analizador con un HTML de muestra: conservó dos enlaces del mismo dominio y excluyó uno externo. El resultado del blog puede variar cuando el sitio cambie.
Añade IA donde realmente ayuda
Después de obtener la lista de fallos, un modelo puede proponer una clasificación: página movida, recurso retirado, error temporal o enlace mal escrito. Pásale únicamente la URL de origen, la URL fallida, el texto del ancla y la respuesta HTTP. Dale esta instrucción:
Clasifica la causa probable del enlace fallido. Sugiere una fuente oficial sustituta solo si puedes verificar que responde al mismo punto del artículo. Si no hay equivalente, recomienda reescribir la frase o retirar la referencia. No inventes URLs y no publiques cambios sin revisión.
El modelo ayuda a priorizar, no a certificar que la nueva referencia sostiene la afirmación. Comprueba el contenido de la página sustituta y registra la fecha de cambio. Para enlaces externos, usa una segunda pasada con límites de tasa y tolera 403 o bloqueos anti-bot: no marques «roto» solo porque un servidor rechazó al script. También conviene probar imágenes embebidas, algo que este ejemplo no hace.
En un blog que publica a diario, añade este control a la revisión semanal de los posts más visitados. Empieza por las páginas con impresiones o clics y guías cuyo procedimiento dependa de fuentes externas. Mantener una buena URL puede rendir más que fabricar una copia nueva.
Fuentes: Python HTMLParser, Python urllib.request y Google Search Central. Código probado localmente y sobre una página de SoyJB el 13 de octubre de 2026.
Recibe lo nuevo en tu correo
Workshops gratis, herramientas y novedades de IA aplicadas a negocio, sin humo.