Caché de prompts de 12 horas: cuándo compensa para tus agentes de IA
OpenAI añadió caché de 12 horas. Compara el costo de 30 minutos y 12 horas con un cálculo reproducible, límites y medición real antes de activarla.
Başlıklar
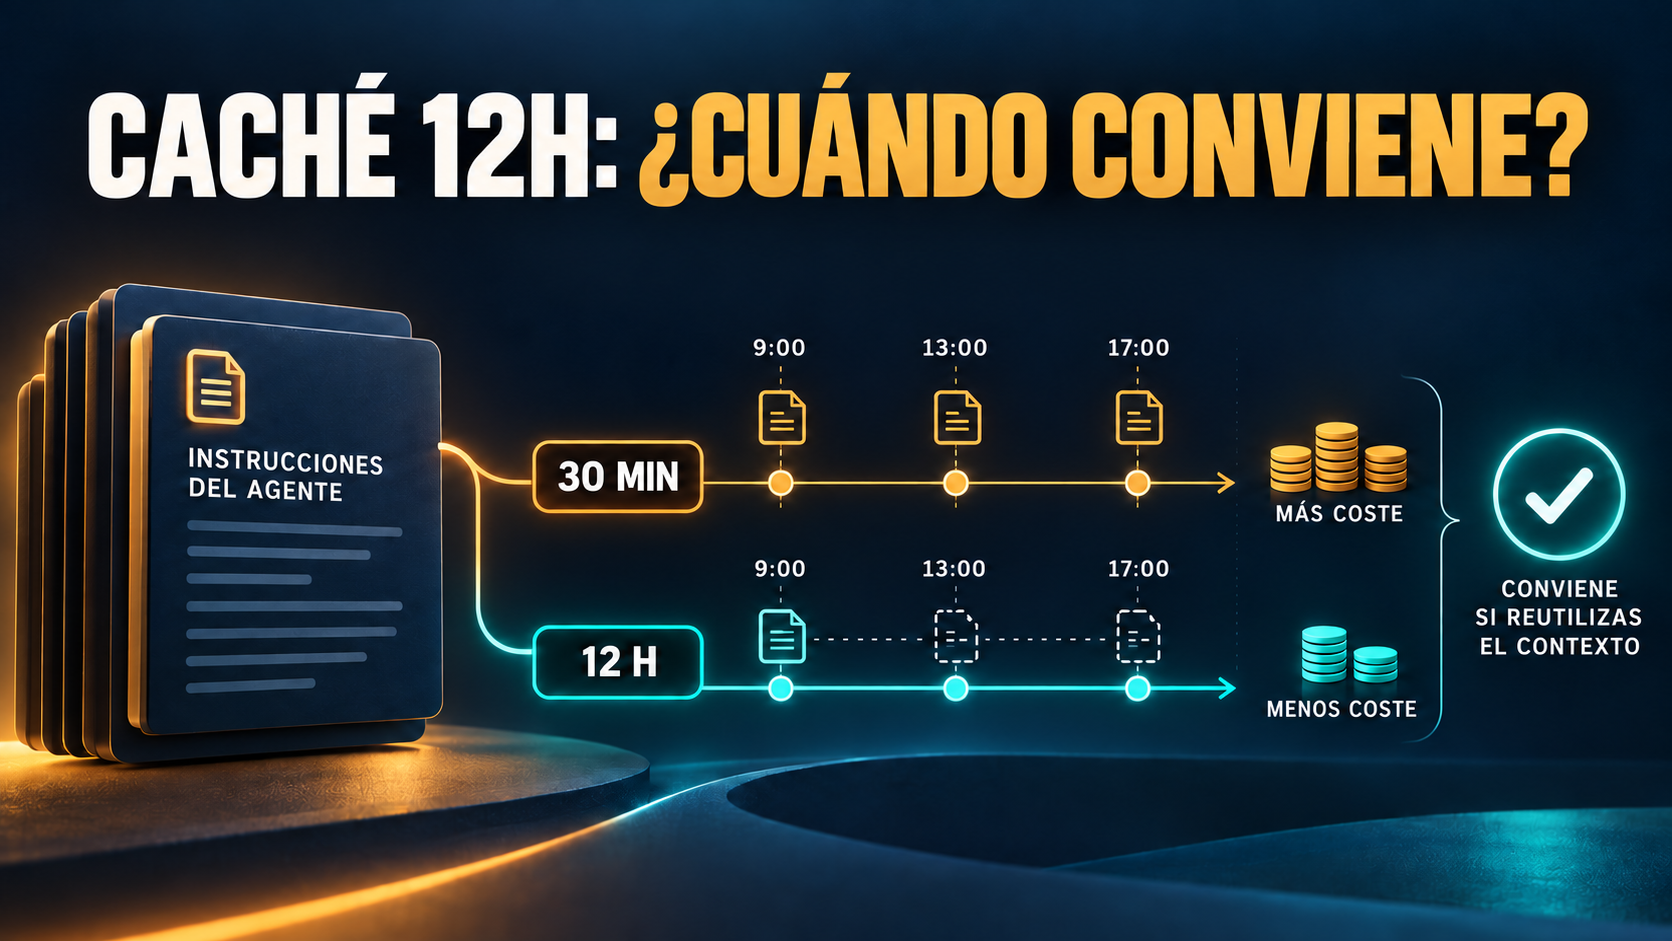
Tu agente de contenido corre a las 9:00, vuelve a las 13:00 y revisa novedades otra vez a las 17:00. En cada ejecución recibe las mismas instrucciones, definiciones de herramientas y criterios editoriales. Si ese prefijo es largo, volver a pagarlo completo puede salir caro. OpenAI añadió el 20 de octubre de 2026 la opción de caché de prompts con duración mínima de 12 horas en la API. La pregunta útil no es “¿activo 12 horas?”, sino cuántas veces reutilizo exactamente el mismo contexto y cuánto me cuesta escribirlo.
El changelog oficial confirma el cambio. En modelos GPT-5.6 y posteriores mediante Responses API, la guía de OpenAI documenta prompt_cache_options.ttl con "30m" por defecto o "12h". Una escritura de 30 minutos cuesta 1,25 veces la tarifa de entrada sin caché; una de 12 horas, 2,5 veces. La lectura tiene una tarifa reducida que depende del modelo. Son multiplicadores de la escritura completa, no recargos adicionales.
Cuándo puede convenirte
Piensa en un asistente que usa el mismo manual de marca y las mismas herramientas varias veces durante el día, con más de media hora entre ejecuciones. Un prefijo estable de al menos 1.024 tokens en GPT-5.6 o posterior puede ser apto para caché. Coloca las instrucciones y referencias compartidas antes de la consulta variable. Si cambias el prefijo, el modelo o la forma del request en cada llamada, la reutilización puede desaparecer. No añadas texto inútil solo para superar el mínimo: cualquier expansión también se factura y debe mejorar, o al menos conservar, la calidad.
Para una conversación corta con muchas solicitudes juntas, 30 minutos puede bastar. Para un agente que se activa varias veces en una jornada, 12 horas podría compensar su escritura más cara. Esa duración es un mínimo de elegibilidad para lecturas en caché; no es una promesa de eliminación de datos a las 12 horas ni una garantía de menor latencia, como aclara la documentación.
Un cálculo que puedes reproducir
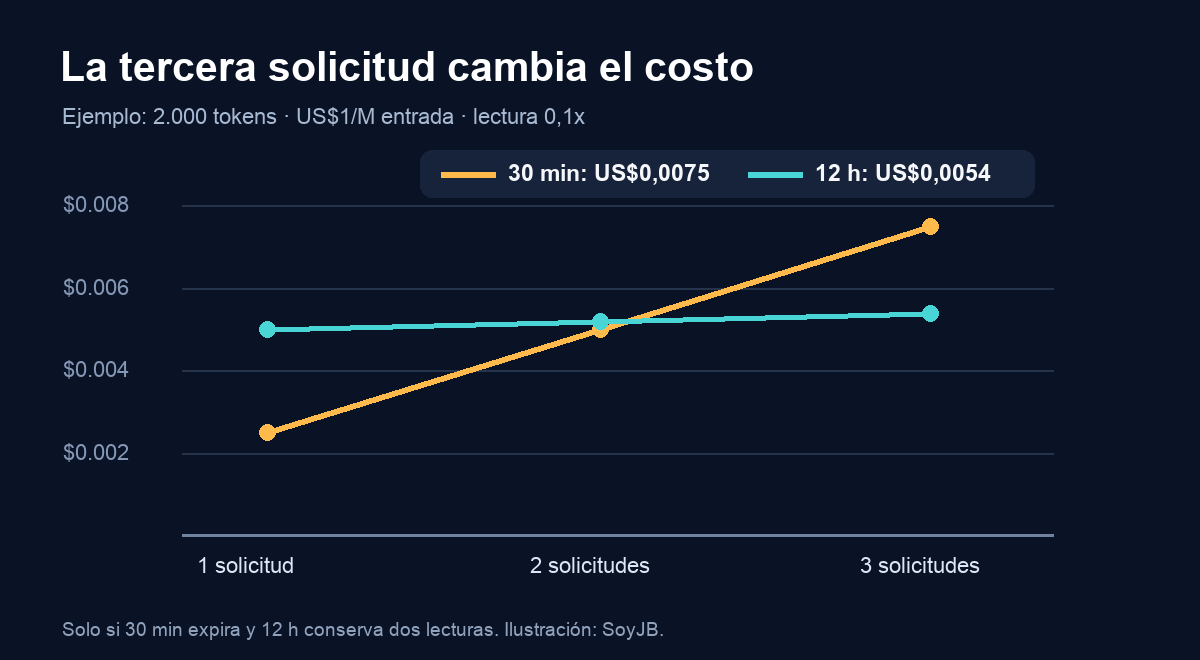
Supongamos un prefijo estable de 2.000 tokens, tres llamadas separadas por cuatro horas y una tarifa ilustrativa de US$1 por millón de tokens de entrada. Para este ejemplo usamos una lectura al 10 % de la tarifa normal, disponible en determinados modelos; comprueba la tarifa real del tuyo. Suponemos que en la opción de 30 minutos cada entrada expiró antes de la siguiente llamada, mientras que la escritura de 12 horas se reutiliza dos veces.
| Solicitudes | 30 minutos | 12 horas |
|---|---|---|
| 1 | US$0,0025 | US$0,0050 |
| 2 | US$0,0050 | US$0,0052 |
| 3 | US$0,0075 | US$0,0054 |
Con esas hipótesis, la tercera solicitud inclina la comparación a favor de 12 horas: US$0,0021 menos en ese prefijo. No es una factura real ni una regla universal. Si una entrada de 30 minutos sigue disponible más tiempo, el resultado cambia. También cambian las cifras si tu modelo tiene otra tarifa de lectura o un prefijo más largo.
prefix_tokens = 2_000
requests = 3
input_usd_per_million = 1.00  # Precio de ejemplo
read_multiplier = 0.10       # Sustituye por la tarifa de tu modelo

def dollars(token_equivalents):
    return token_equivalents * input_usd_per_million / 1_000_000

# Supone una nueva escritura 30m en cada solicitud.
cost_30m = dollars(prefix_tokens * requests * 1.25)
# Supone una escritura 12h y dos lecturas de caché.
cost_12h = dollars(prefix_tokens * (2.5 + (requests - 1) * read_multiplier))

print(f"30m: ${cost_30m:.4f}")
print(f"12h: ${cost_12h:.4f}")
Probamos localmente la sintaxis y el cálculo: devuelve US$0,0075 y US$0,0054 con estos supuestos. No ejecutamos una petición pagada a OpenAI. Para activar la opción en un request compatible de Responses, la forma documentada es "prompt_cache_options": {"ttl": "12h"}; confirma en la guía el modo y el modelo que usas antes de desplegarlo.
Prueba en producción sin engañarte con el promedio
- Identifica el prefijo fijo. Congela instrucciones y herramientas compartidas; coloca el material que cambia después. Comprueba el mínimo cacheable del modelo y que los requests conservan la misma secuencia.
- Corre una prueba A/B con el mismo trabajo. Compara 30 minutos y 12 horas en horarios reales, sin cambiar prompt, modelo ni tamaño del lote entre grupos.
- Lee el uso que devuelve la API. Registra
cached_tokens,cache_write_tokens, desglose por TTL cuando exista, latencia y costo calculado con la tarifa vigente. No sumes dos veces los tokens de escritura: ya están incluidos en la entrada total. - Revisa datos y límites. La duración de caché no define por sí sola la política máxima de retención. Confirma requisitos de privacidad y que el modelo admite este control.
La decisión práctica: si tu agente repite un contexto amplio durante el día, mide el tercer y cuarto uso antes de adoptar 12 horas. Si el contenido cambia en cada llamada o el prefijo no alcanza el mínimo, optimiza primero el prompt. Fuente principal: guía de prompt caching de OpenAI; fecha del cambio: 20 de octubre de 2026.
Recibe lo nuevo en tu correo
Workshops gratis, herramientas y novedades de IA aplicadas a negocio, sin humo.