Cómo detectar enlaces de fuentes rotas en tus artículos de IA
Script de Python que revisa referencias externas y separa 404 reales de errores temporales antes de actualizar un post.
Başlıklar
Publicas una guía sobre una función de IA y enlazas el anuncio oficial. Tres meses después, la empresa reorganiza sus docs y ese enlace devuelve 404. El lector pierde la prueba de lo que afirmas y tu artículo envejece peor de lo necesario. Con muchos posts, abrir a mano cada referencia deja de ser realista.
Esta automatización toma el HTML de un artículo, extrae sus enlaces externos y clasifica la respuesta HTTP. No cambia el texto ni borra enlaces por sí sola: un 403 puede ser un bloqueo al bot y un 429 significa que conviene esperar. Su objetivo es darte una lista corta de enlaces que necesitan revisión humana.
Un verificador pequeño y respetuoso
Guarda el contenido HTML de un post en articulo.html y copia este script como revisar_fuentes.py. Usa la biblioteca estándar de Python; limita la revisión a 20 URLs únicas y espera entre solicitudes.
from html.parser import HTMLParser
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen
import sys
import time

class Enlaces(HTMLParser):
    def __init__(self):
        super().__init__()
        self.urls = []
    def handle_starttag(self, tag, attrs):
        if tag != "a":
            return
        href = dict(attrs).get("href", "")
        if href.startswith("https://") and href not in self.urls:
            self.urls.append(href)

def estado(url):
    req = Request(url, headers={"User-Agent": "SoyJB-LinkCheck/1.0"})
    try:
        with urlopen(req, timeout=10) as respuesta:
            respuesta.read(1)
            codigo = respuesta.status
    except HTTPError as error:
        codigo = error.code
    except (URLError, TimeoutError):
        return "REVISAR: conexión o tiempo"
    if codigo in (404, 410):
        return f"ROTO: HTTP {codigo}"
    if codigo in (403, 429) or codigo >= 500:
        return f"REVISAR: HTTP {codigo}"
    return f"OK: HTTP {codigo}"

if __name__ == "__main__":
    html = Path(sys.argv[1]).read_text(encoding="utf-8")
    parser = Enlaces()
    parser.feed(html)
    for url in parser.urls[:20]:
        print(estado(url), url)
        time.sleep(0.5)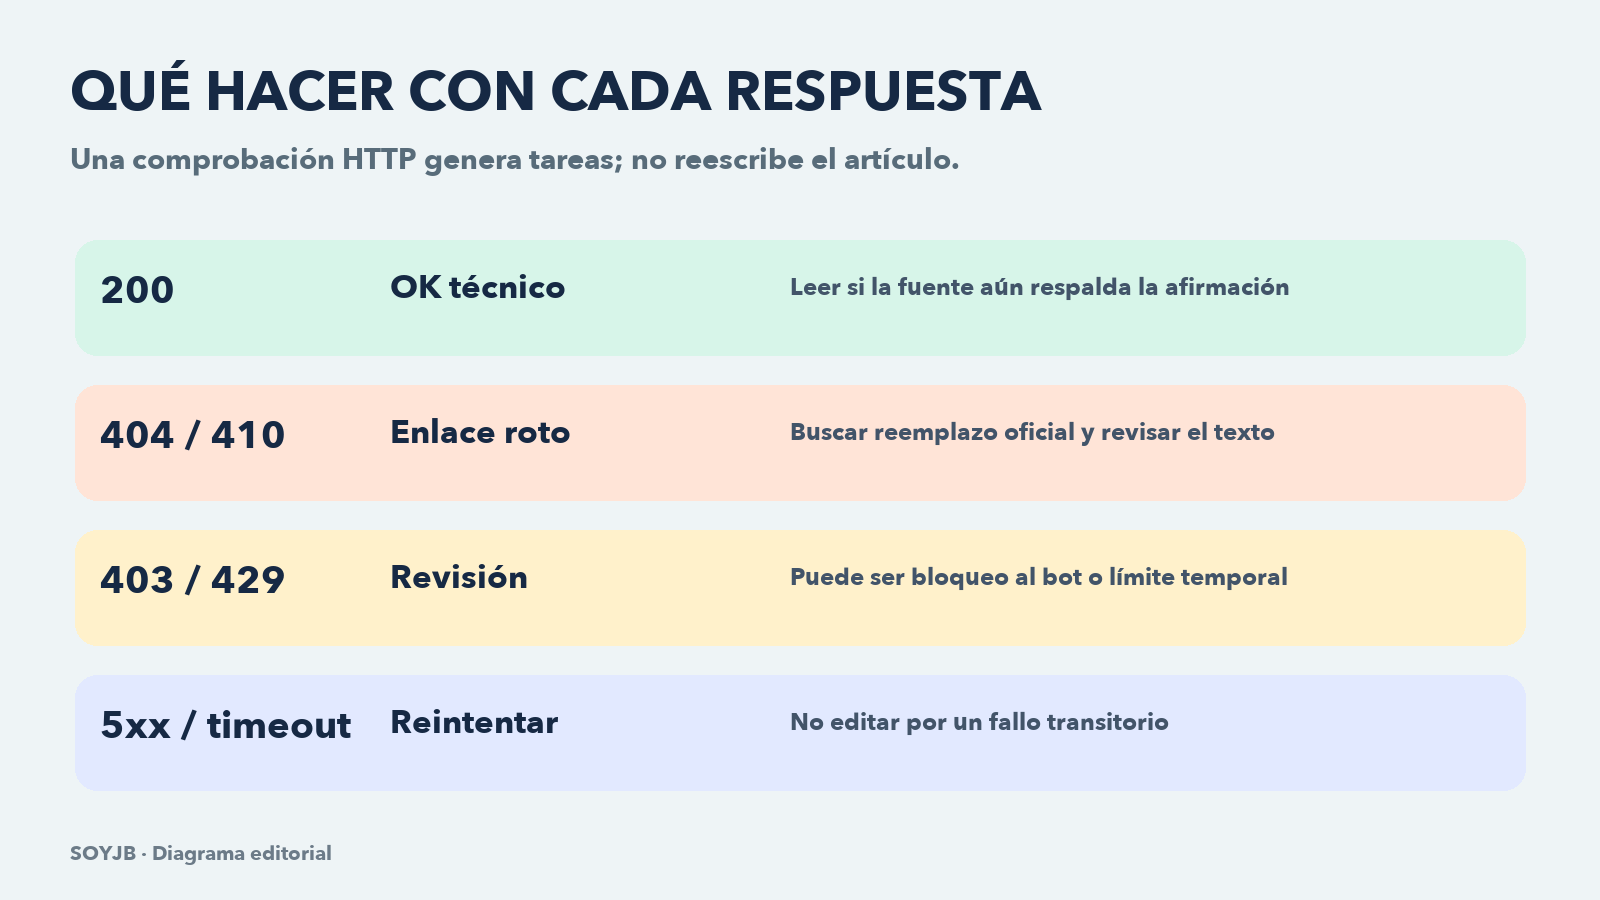
Ejecuta python revisar_fuentes.py articulo.html. Una respuesta OK: HTTP 200 indica que la URL respondió a esta solicitud; no demuestra que el contenido siga diciendo lo mismo. ROTO: HTTP 404 o 410 suele exigir actualizar el enlace. REVISAR pide abrir la página en un navegador o consultar la documentación oficial antes de tomar una decisión.
Cómo integrarlo en una rutina editorial
Una vez por semana, exporta el HTML de los artículos más visitados y los posts que dependen de anuncios que cambian rápido: precios, nombres de modelo, disponibilidad o límites de API. Ejecuta el script con una pausa y revisa solo los resultados problemáticos. Si el proveedor movió la documentación, busca la nueva URL en su sitio oficial; si eliminó la función, actualiza también la explicación del artículo y pon la fecha de la revisión. Cambiar únicamente el enlace puede dejar una afirmación falsa.
Para un blog automatizado, la salida debería crear tareas, no reescribir posts a ciegas. Añade al registro el ID del post, URL de origen, URL revisada, estado y fecha. No abras un artículo nuevo para corregir una referencia: conserva la URL original del post y mejora la pieza existente.
Ordena por impacto: primero revisa enlaces de páginas que ya reciben clics en Search Console y que sostienen una afirmación central. Una referencia rota en una nota al pie importa menos que la página de precios que fundamenta una recomendación de compra. Después mira artículos recientes sobre cambios de producto, porque una fuente puede seguir respondiendo 200 aunque el proveedor haya actualizado la información. Para cada corrección, anota qué frase cambió y qué documento oficial la respalda; así la revisión deja evidencia útil para el siguiente editor.
Las limitaciones importan
Algunos sitios bloquean solicitudes automáticas, redirigen por región o requieren JavaScript. Un 403 no equivale a una fuente muerta; tampoco un 200 garantiza que la página mantenga el anuncio que citaste. Si el enlace termina en una cadena de redirecciones, comprueba manualmente el destino final antes de aceptarlo. Este script no rastrea imágenes ni archivos PDF de manera especial y solo procesa hasta 20 enlaces por archivo para evitar golpear muchos servidores en una pasada. Respeta las condiciones del sitio y no repitas agresivamente respuestas 429.
Probé la extracción de enlaces, la clasificación de 200, 404 y 429 mediante un cliente simulado y la ejecución con una página pública de documentación; antes de conectarlo a un lote grande, revisa la política de acceso de cada fuente. La ganancia está en detectar temprano qué merece lectura humana, no en publicar automáticamente una corrección sin contexto.
Fuentes: HTMLParser y urllib.request, documentación oficial de Python.
Recibe lo nuevo en tu correo
Workshops gratis, herramientas y novedades de IA aplicadas a negocio, sin humo.