Cómo evitar que una automatización con IA procese dos veces el mismo evento
Una cola mínima con Python y SQLite que detecta eventos nuevos, repetidos y conflictos antes de llamar al modelo.
Başlıklar
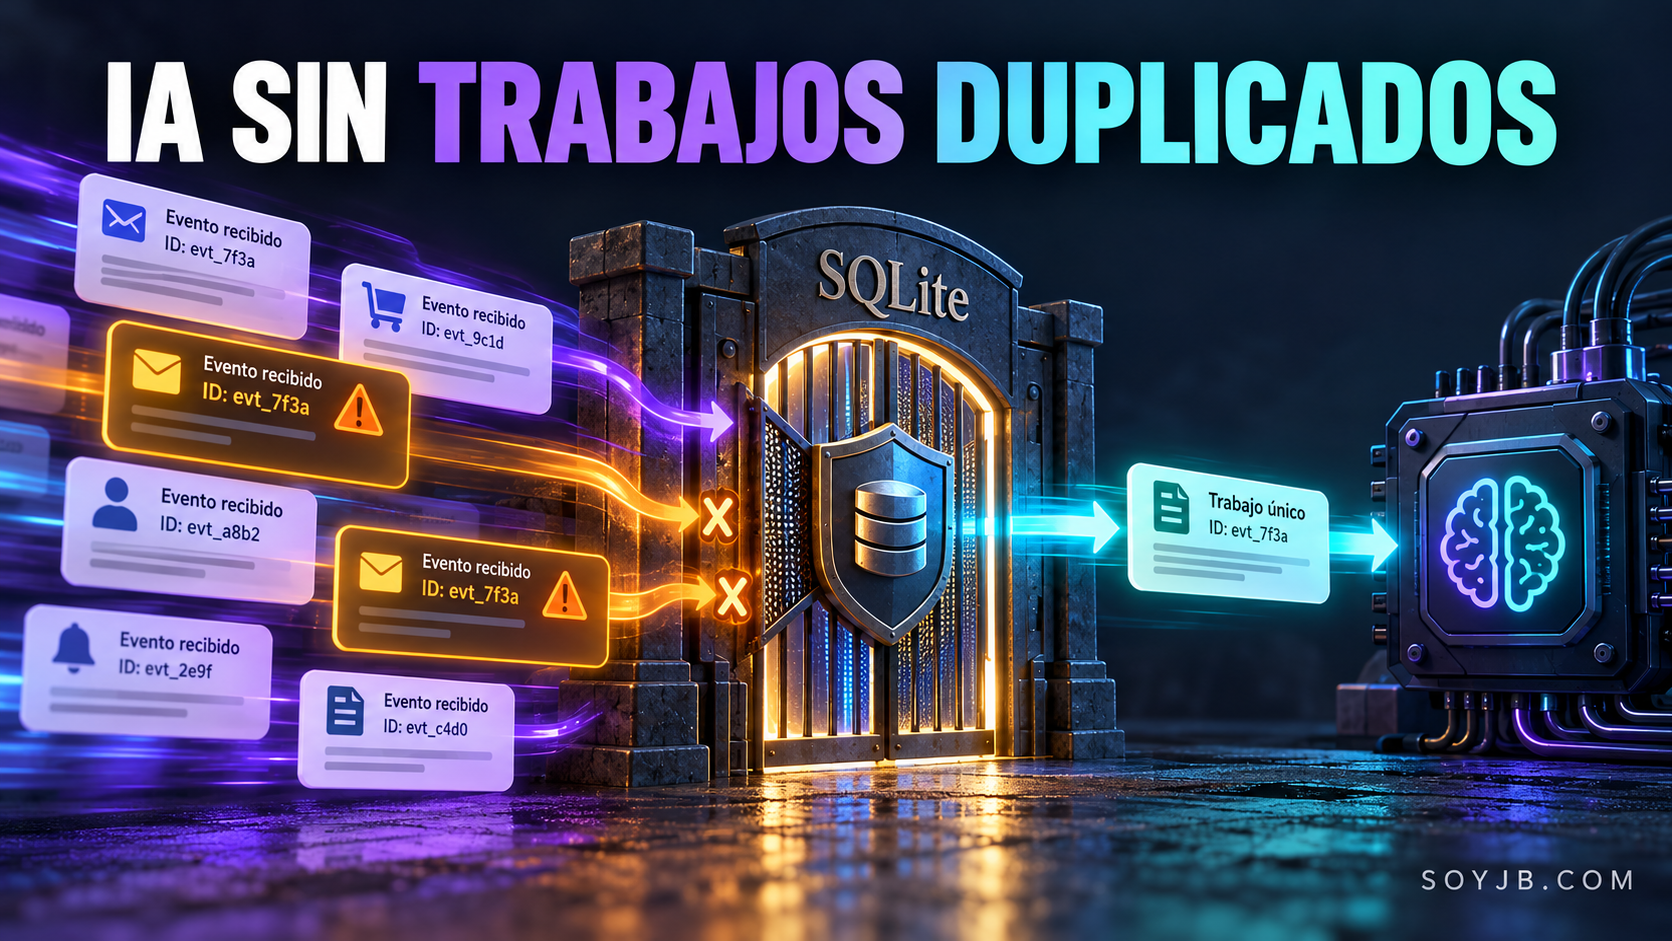
Tu formulario recibe una idea para el blog, dispara un flujo de IA y la red falla justo después de enviar la respuesta. El proveedor reintenta el evento. Si tu pipeline trata cada entrega como nueva, pagas dos análisis y puedes crear dos borradores idénticos. Este problema aparece antes de elegir modelo: falta una identidad estable para cada evento.
Vamos a construir una bandeja mínima con SQLite que acepta eventos en formato JSON Lines. Cada evento tiene id y texto; el mismo ID solo entra una vez. Si llega un ID igual con contenido distinto, el programa lo reporta como conflicto en lugar de esconderlo. Sirve como primer filtro para formularios, webhooks o tareas programadas que preparan trabajos para IA.
La regla: deduplicar antes de llamar al modelo
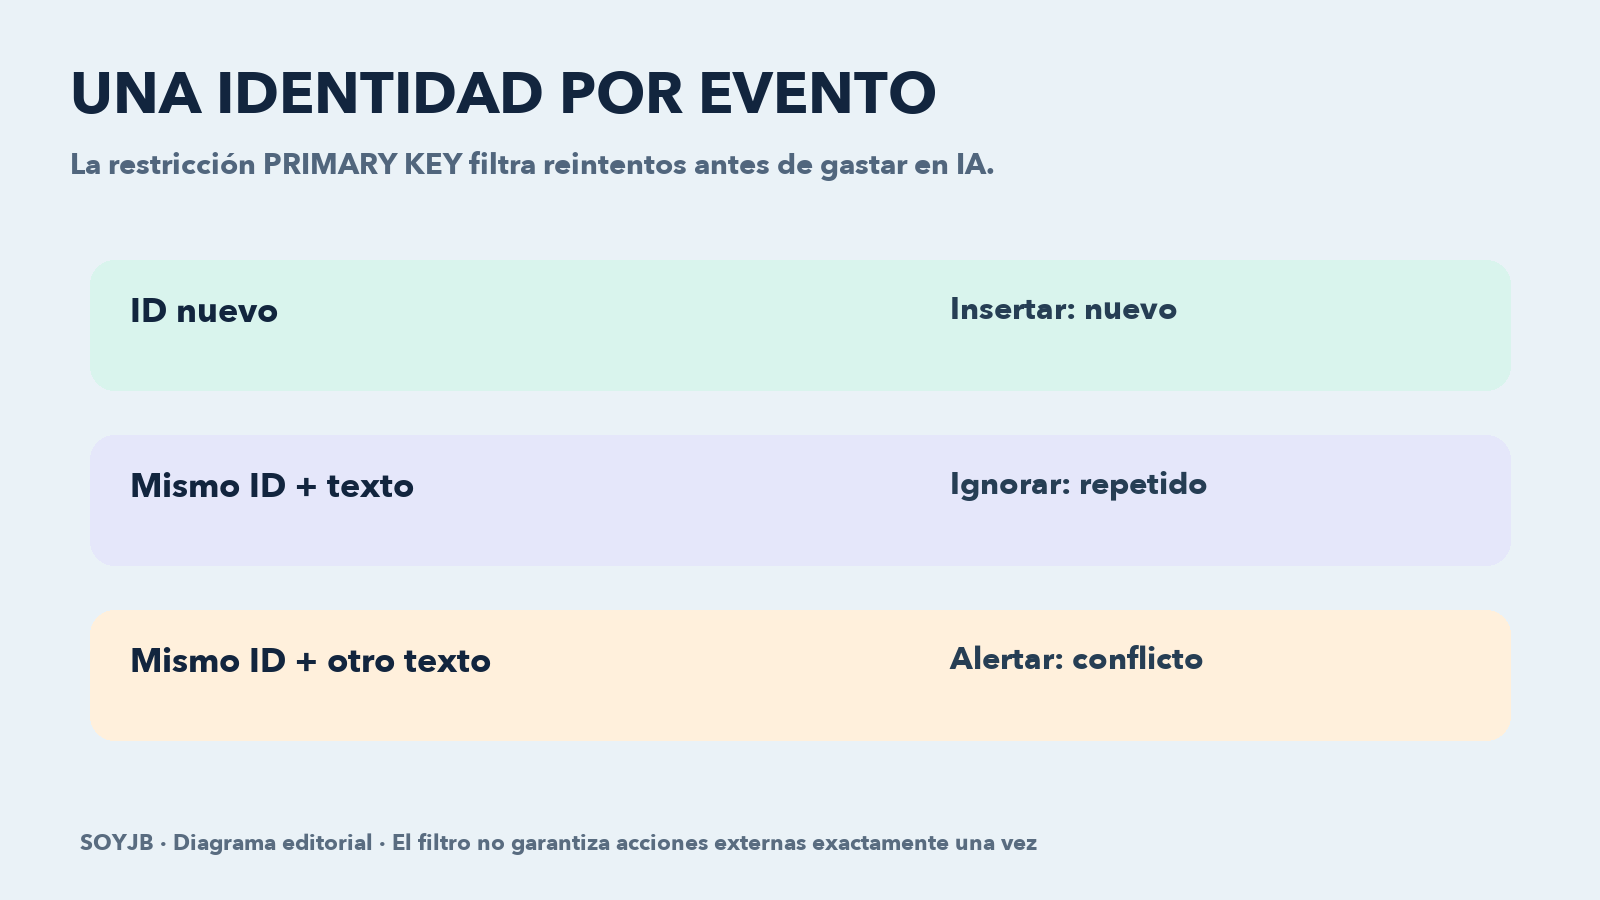
Guarda el ID que trae el proveedor. Si no existe, crea uno en el origen y consérvalo en los reintentos. No uses el título del artículo como clave: dos mensajes distintos pueden compartir título, y el mismo mensaje puede cambiar de título después de editarlo. Una restricción PRIMARY KEY en SQLite hace que la identidad sea persistente y atómica.
Copia este archivo como cola_ia.py; usa solo la biblioteca estándar de Python:
import hashlib
import json
import sqlite3
import sys

DB = "cola_ia.sqlite3"

def abrir():
    con = sqlite3.connect(DB)
    con.execute("""
        CREATE TABLE IF NOT EXISTS trabajos (
            id TEXT PRIMARY KEY,
            texto TEXT NOT NULL,
            huella TEXT NOT NULL,
            estado TEXT NOT NULL DEFAULT 'pendiente'
        )
    """)
    con.commit()
    return con

def agregar(con, evento):
    ident = evento["id"]
    texto = evento["texto"]
    if not isinstance(ident, str) or not ident.strip():
        raise ValueError("id inválido")
    if not isinstance(texto, str) or not texto.strip():
        raise ValueError("texto vacío")
    huella = hashlib.sha256(texto.encode("utf-8")).hexdigest()
    with con:
        cur = con.execute(
            "INSERT OR IGNORE INTO trabajos (id, texto, huella) "
            "VALUES (?, ?, ?)",
            (ident, texto, huella),
        )
        if cur.rowcount == 1:
            return "nuevo"
        anterior = con.execute(
            "SELECT huella FROM trabajos WHERE id = ?", (ident,)
        ).fetchone()[0]
        return "repetido" if anterior == huella else "conflicto"

if __name__ == "__main__":
    con = abrir()
    for linea in open(sys.argv[1], encoding="utf-8"):
        if linea.strip():
            evento = json.loads(linea)
            print(evento["id"], agregar(con, evento))
    con.close()
Prepara eventos.jsonl con estas tres líneas:
{"id":"idea-42","texto":"Comparar dos modelos en mi producto"}
{"id":"idea-42","texto":"Comparar dos modelos en mi producto"}
{"id":"idea-42","texto":"Publicar sin revisión humana"}
Ejecuta python cola_ia.py eventos.jsonl. La primera línea devuelve nuevo, la segunda repetido y la tercera conflicto. Si vuelves a ejecutar el comando, la primera ya aparecerá como repetida porque SQLite conservó el registro. El caso de conflicto es una alarma útil: probablemente alguien reutilizó un ID o cambió el contenido de un evento que debía ser inmutable.
Antes de enchufar un webhook: verifica la firma del proveedor en el receptor, limita el tamaño de la carga y extrae únicamente el ID y el texto que necesitas. Este script lee un archivo local: no implementa autenticación ni un servidor HTTP. En una integración real, registra también la fecha de recepción y el tipo de evento. Así puedes investigar por qué una entrega llegó tarde sin reconstruir la historia desde los logs del proveedor.
Lo que este filtro sí y no resuelve
La cola evita insertar dos veces el mismo trabajo. No garantiza que una acción externa ocurra exactamente una vez. Si un trabajador publica un post y se cae antes de marcarlo como terminado, un reintento podría volver a publicar. Para ese paso, consulta el ID del post remoto antes de repetir y usa una clave de idempotencia si la API del destino la ofrece. La misma idea se aplica a pagos: Stripe documenta claves de idempotencia para reintentos de solicitudes de escritura.
Para procesar los registros, añade estados pendiente, en_proceso y terminado, y registra el ID del recurso creado por la API de IA o del blog. Considera un mecanismo de recuperación de trabajos atascados y registros de errores. El ejemplo de arriba es deliberadamente una puerta de entrada, no una cola distribuida de producción.
Mi prueba mínima antes de conectar una IA: ejecuta el archivo dos veces, cambia el texto de un ID existente, crea un ID nuevo y comprueba que solo los nuevos registros pasan a la siguiente fase. Así puedes crecer el volumen sin multiplicar silenciosamente borradores o costos cada vez que una red reintenta.
Fuentes: documentación oficial de sqlite3 en Python y guía oficial de idempotencia de Stripe. El código usa la biblioteca estándar y se puede probar sin claves ni gasto de API.
Recibe lo nuevo en tu correo
Workshops gratis, herramientas y novedades de IA aplicadas a negocio, sin humo.