Un radar de IA con fuentes oficiales que no repite enlaces
Crea un radar RSS de IA en Python con fuentes oficiales, filtro de 48 horas y estado persistente. Código probado y un criterio para decidir qué merece publicarse.
Başlıklar
Quieres enterarte de una actualización de IA antes de escribir sobre ella, pero abrir veinte cuentas de X cada mañana acaba mezclando anuncios, opiniones y rumores. Un radar pequeño puede hacer la primera criba: lee canales oficiales, muestra solo enlaces nuevos y deja la decisión editorial para después de abrir la fuente.
Este ejemplo consulta dos canales reales: el RSS del GitHub Changelog y el RSS de Google AI. Ambos respondieron con XML fechado por artículo durante la prueba del 13 de octubre de 2026. No forman un radar completo de toda la industria; son un punto de partida que puedes ejecutar sin API de X ni servicio de pago.
Qué hace y qué no hace
El script lee publicaciones de las últimas 48 horas, elimina parámetros de seguimiento de las URL, deduplica enlaces y guarda los ya mostrados en radar_ia_seen.json. La primera ejecución del 13 de octubre mostró cinco entradas recientes de GitHub; una segunda ejecución no repitió ninguna. Google no tenía nuevas entradas dentro de esa ventana en el momento de la prueba. Eso es normal: una fuente sin novedades no es una conexión rota.
El radar devuelve candidatos, no artículos listos. Un titular en RSS no demuestra disponibilidad, precio, fecha de lanzamiento ni utilidad para tus lectores. Antes de publicar, abre el enlace original y revisa la documentación o producto; para X, usa el post del autor como pista y sigue hasta una fuente primaria. Ese paso editorial evita convertir cada frase viral en una “novedad”.
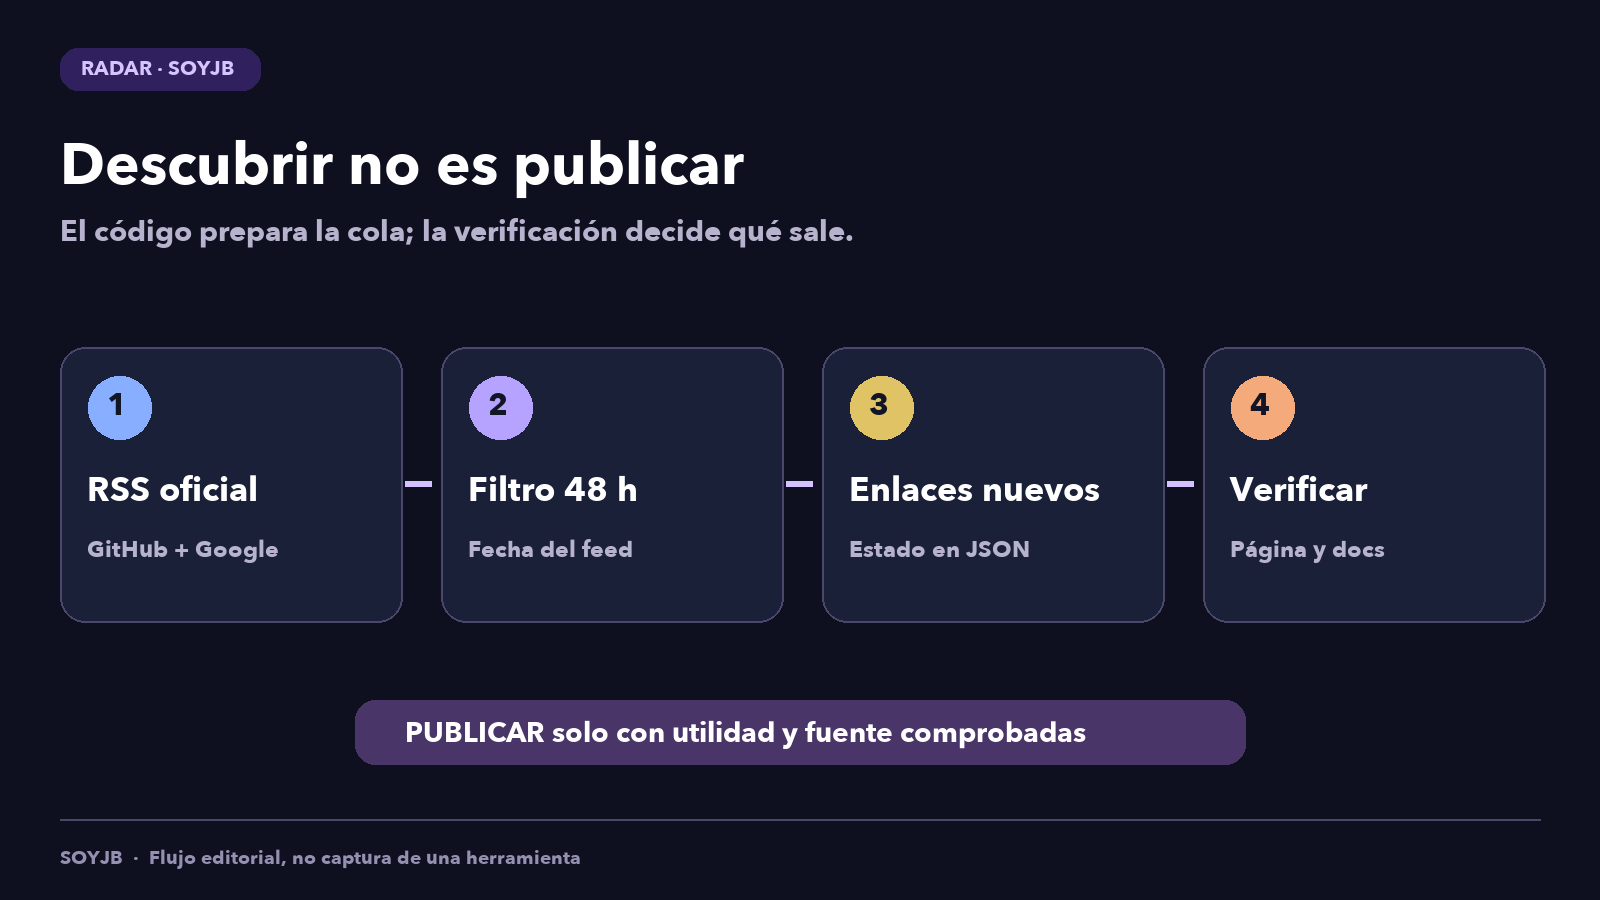
El filtro automatiza el hallazgo; la comprobación de la noticia sigue siendo editorial.
Copia y prueba el radar
Guarda el siguiente archivo como radar_ia_rss.py. Necesitas Python 3.9 o posterior y conexión a internet. No requiere paquetes adicionales. Ejecuta python3 radar_ia_rss.py desde la terminal. El archivo JSON de estado se creará junto al script; si lo borras, la siguiente ejecución tratará los enlaces recientes como nuevos otra vez.
"""Radar inicial de anuncios; revisa las páginas originales antes de publicar."""

import json
from pathlib import Path
from datetime import datetime, timedelta, timezone
from email.utils import parsedate_to_datetime
from urllib.parse import urlsplit, urlunsplit
from urllib.request import Request, urlopen
from xml.etree import ElementTree as ET

FEEDS = {
    "GitHub Changelog": "https://github.blog/changelog/feed/",
    "Google AI Blog": "https://blog.google/technology/ai/rss/",
}
HOURS = 48
STATE = Path(__file__).with_name("radar_ia_seen.json")
now = datetime.now(timezone.utc)
cutoff = now - timedelta(hours=HOURS)
found = {}
seen = set(json.loads(STATE.read_text())) if STATE.exists() else set()

for source, url in FEEDS.items():
    try:
        request = Request(url, headers={"User-Agent": "SoyJB-Radar/1.0"})
        with urlopen(request, timeout=15) as response:
            xml = ET.fromstring(response.read())
    except Exception as exc:
        print(f"AVISO: no se pudo leer {source}: {exc}")
        continue

    for item in xml.findall("./channel/item"):
        title = (item.findtext("title") or "").strip()
        link = (item.findtext("link") or "").strip()
        published = (item.findtext("pubDate") or "").strip()
        if not title or not link or not published:
            continue
        try:
            date = parsedate_to_datetime(published).astimezone(timezone.utc)
        except (TypeError, ValueError):
            continue
        if date < cutoff or date > now + timedelta(minutes=5):
            continue
        parts = urlsplit(link)
        canonical = urlunsplit((parts.scheme, parts.netloc, parts.path.rstrip("/"), "", ""))
        found[canonical] = (date, source, title, canonical)

new = (row for link, row in found.items() if link not in seen)
rows = sorted(new, reverse=True)[:20]
for date, source, title, link in rows:
    print(f"{date:%Y-%m-%d %H:%M} UTC | {source} | {title}\n  {link}")

STATE.write_text(json.dumps(sorted(seen | {row[3] for row in rows}), indent=2) + "\n")
En la prueba de hoy, la salida incluyó “Client telemetry user attribution and configurable capture”, con fecha de publicación y URL de GitHub. Ese enlace llevó a una noticia aplicable sobre cómo atribuir actividad de Copilot sin capturar prompts. El script solo encontró la pista; la verificación de controles y límites vino del anuncio y la documentación de GitHub.
Convierte enlaces en una cola útil
Para cada candidato, anota cuatro cosas antes de redactar: qué cambió realmente, quién puede usarlo, qué tarea resuelve y qué prueba o decisión puede hacer hoy el lector. Si falta una respuesta, deja el tema en investigación. Un post de X puede ayudarte a detectar preguntas de la audiencia, pero la afirmación técnica debe salir de una página oficial o de una prueba que puedas describir.
Si quieres ampliar el radar, añade feeds oficiales que hayas probado con el mismo procedimiento. No supongas que toda empresa publica RSS accesible: algunas URL dan 403 o 404, como ocurrió con canales que evalué para este ejemplo. El script informa fallos de lectura y continúa con las fuentes sanas; revisa esos avisos antes de interpretar una mañana vacía como “no pasó nada”.
Programa una ejecución diaria en la zona horaria de tu audiencia y guarda su salida como lista de candidatos. El archivo radar_ia_seen.json evita repetir los enlaces que ya mostró, aunque no sustituye la comprobación de duplicados en tu blog: dos anuncios pueden describir la misma intención, y una actualización puede merecer corregir una URL existente. El siguiente paso del sistema es la revisión humana o asistida con fuentes abiertas, no un botón que publique cada entrada del feed.
Recibe lo nuevo en tu correo
Workshops gratis, herramientas y novedades de IA aplicadas a negocio, sin humo.