Si tu app deja que una IA decida qué tickets necesitan revisión humana, cambiar de modelo por una promesa de mayor precisión puede mover casos delicados al carril equivocado. Microsoft Decision‑1.1 llegó a Vercel AI Gateway el 17 de noviembre de 2026. Vercel afirma que supera a Decision‑1 en precisión, calibración y velocidad, y que acepta el mismo formato de solicitud: para migrar basta cambiar el identificador a microsoft/decision-1.1. Esa compatibilidad facilita la prueba; no demuestra que funcione mejor con tus datos.
La decisión de esta semana: ¿migrar o medir?
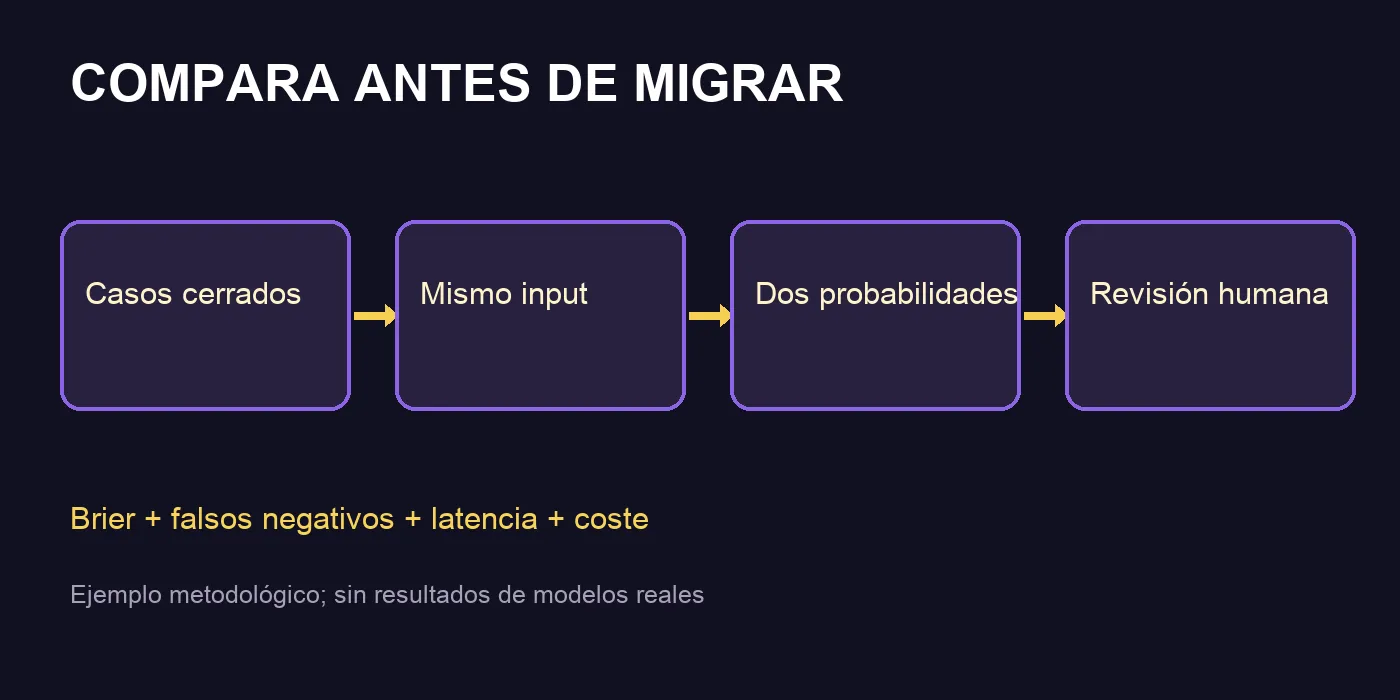
Usa un conjunto de tickets históricos resueltos y anonimizados. Para cada uno, define antes de llamar a los modelos una pregunta binaria observable: «¿Requirió intervención humana?». Guarda la etiqueta real, la probabilidad de Decision‑1, la de Decision‑1.1, el tiempo de respuesta y el coste que muestre tu cuenta. Mantén igual el texto de entrada y la definición de la pregunta en ambas corridas. Si cambias prompt, umbral y modelo a la vez, no sabrás qué causó una diferencia.
La API ofrece formatos de decisión Boolean, Choice y Score. Para una primera comparación, Boolean basta: una probabilidad de intervención humana y una etiqueta 0 o 1 por caso. No uses tickets con datos personales sin autorización; elimina nombres, correos y detalles de pagos. Si hay información médica, financiera o legal, conserva revisión humana y una política específica del dominio.
Un experimento pequeño y reproducible
- Selecciona, por ejemplo, 30 casos ya cerrados: casos fáciles, urgentes y ambiguos. Esa cantidad sirve para detectar errores evidentes, no para estimar con precisión el rendimiento de producción.
- Obtén las dos probabilidades con el mismo input y registra los errores de API. El anuncio indica que cambiar el model ID mantiene el formato, pero revisa la respuesta y el precio vigente en AI Gateway antes de integrar.
- Calcula una métrica de calibración como Brier y mira cada falso negativo: tickets que necesitaban una persona pero recibieron probabilidad baja. Compara también latencia y gasto reales de tu cuenta.
- Elige un umbral conservador en los casos históricos. Aplica ambos modelos en modo sombra a tickets nuevos: registra predicciones sin automatizar decisiones. Solo considera migrar tras revisar esos resultados con el equipo.
Este código calcula Brier sobre probabilidades y etiquetas ya guardadas. Un valor menor es mejor; cero significa predicción perfecta. El vector de ejemplo es inventado para enseñar el cálculo, no contiene resultados de Decision‑1 ni Decision‑1.1:
def brier(probabilities, labels):
    if len(probabilities) != len(labels) or not probabilities:
        raise ValueError('Aligned, non-empty lists required')
    if any(not 0 <= p <= 1 for p in probabilities):
        raise ValueError('Probabilities must be 0..1')
    if any(y not in (0, 1) for y in labels):
        raise ValueError('Labels must be 0 or 1')
    return sum((p - y) ** 2 for p, y in zip(probabilities, labels)) / len(labels)

print(brier([0.9, 0.2, 0.7], [1, 0, 0]))  # 0.18
Ejecuté ese ejemplo localmente y devolvió 0.18. El promedio puede ocultar un fallo grave; revisa la tabla de casos, sobre todo los que etiquetaste como urgentes. Una predicción de 0.49 frente a un umbral de 0.50 no es una «certeza negativa». Puedes enviar a revisión humana todo caso cercano al corte o con una señal de riesgo independiente.
Acceso y límites
Decision‑1.1 está disponible por AI Gateway con una clave y el identificador indicado; Vercel menciona presupuestos, registros y fallbacks. La disponibilidad efectiva y facturación dependen de tu proyecto. La página del modelo muestra precio por tokens, que puede cambiar; evita convertirlo en «precio por ticket» sin medir el tamaño de tus solicitudes. La afirmación de mayor precisión y velocidad procede del anuncio del proveedor. Aquí no se ejecutaron llamadas pagadas ni se midió Decision‑1.1 con tickets reales, por lo que no hay ganador declarado.
Fuentes: anuncio de Vercel, 17 nov 2026; ficha del modelo en AI Gateway.