Tu MVP recibe comentarios de clientes por correo, chat y formularios. Necesitas separar bugs urgentes, dudas de precio e ideas de producto antes de que alguien responda. El 16 de noviembre de 2026, la ficha oficial de Vercel AI Gateway ya muestra Tencent Hy4 Flash como una opción para probar ese trabajo con una sola integración. La decisión útil no es cambiar todos tus flujos hoy, sino comprobar si clasifica tus mensajes con suficiente consistencia a un costo que te convenga.
Qué está disponible
El identificador en AI Gateway es tencent/hy4-flash. Vercel indica acceso por AI SDK y sus formatos de API compatibles; la ficha muestra fecha de incorporación 16/11/2026, ventana de contexto de hasta 1 millón de tokens y máximo de salida de 64.000. También declara soporte para razonamiento, llamadas a herramientas, salidas estructuradas, caché de prompts y comprensión de imágenes. Esas capacidades son datos de la ficha del proveedor, no resultados medidos por SoyJB.
Al consultarla hoy, la tarifa publicada es US$0,04 por millón de tokens de entrada y US$0,14 por millón de salida, señalada como promoción del 50 %. El anuncio oficial de Vercel del 16 de noviembre aclara que el descuento introductorio cubre entrada, entrada en caché y salida hasta el 29 de noviembre de 2026. No indica una hora de publicación. Verifica el precio vigente antes de automatizar volumen: después de la promoción puede cambiar. El uso se factura mediante el equipo de AI Gateway conforme a sus condiciones y a las del proveedor Tencent Cloud.
Una prueba de hoy para fundadores
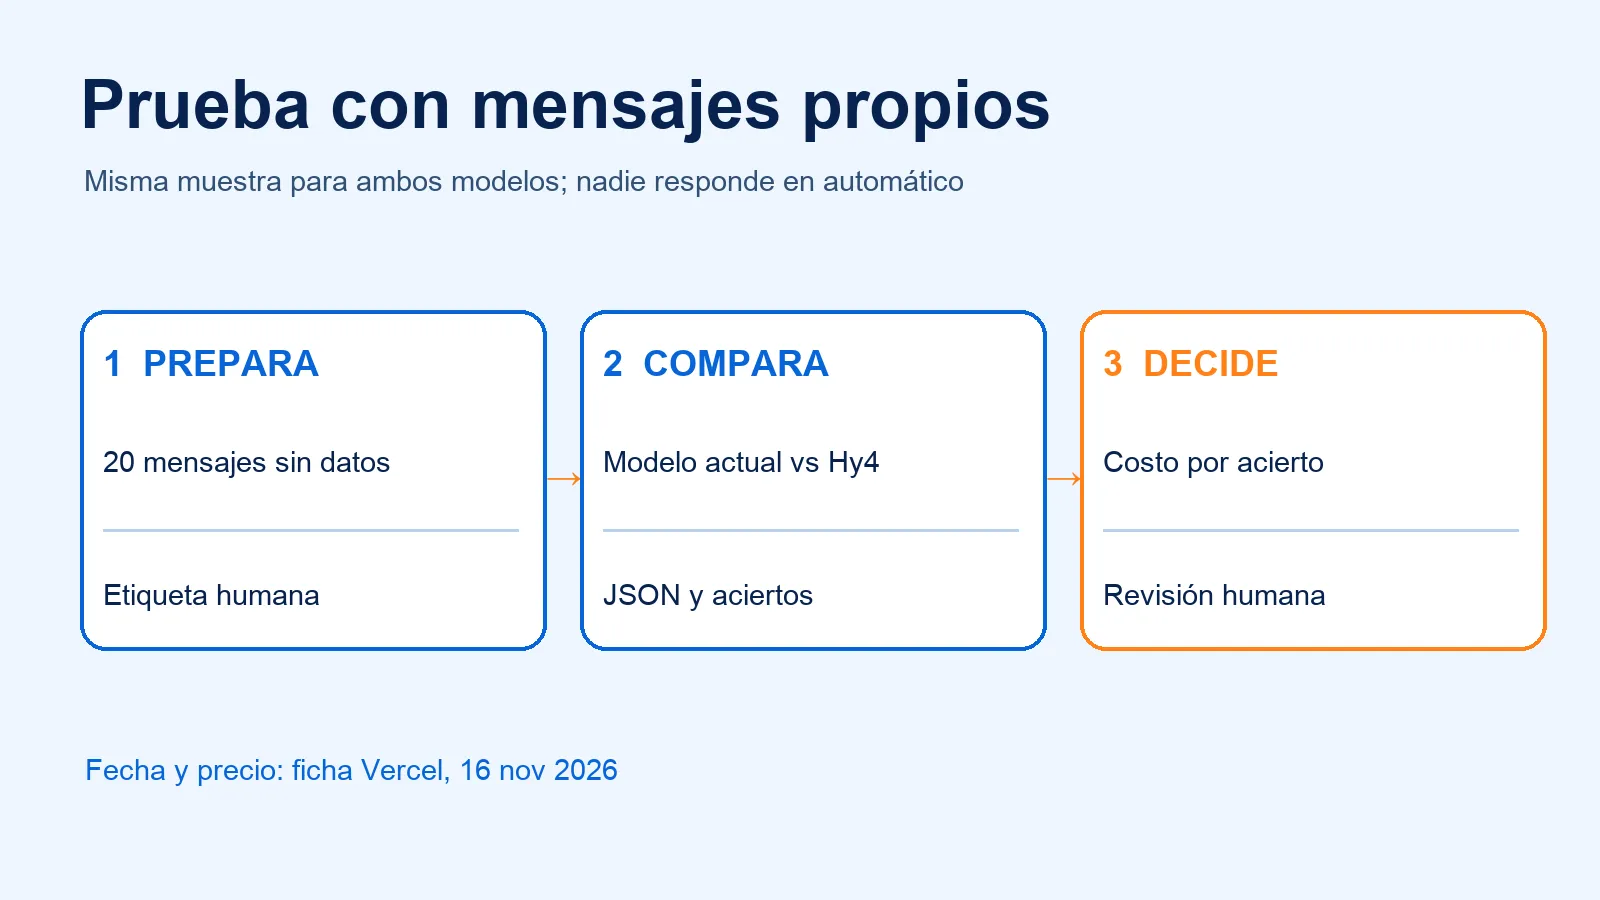
Elige veinte mensajes reales de tu producto, quita nombres, correos y datos sensibles, y etiqueta manualmente cada uno como bug, precio, solicitud u otro. Deja por escrito cuál es urgente y por qué. Luego ejecuta el mismo lote con tu modelo actual y con Hy4 Flash usando una instrucción fija:
Clasifica el mensaje de un cliente. Devuelve solamente JSON con las claves tipo (bug|precio|solicitud|otro), prioridad (alta|media|baja) y resumen (máximo 15 palabras). No inventes datos. Si falta información, usa otro y explica la duda en resumen. Mensaje: {{MENSAJE_ANONIMIZADO}}Para llamarlo desde AI SDK, Vercel muestra el patrón generateText({ model: 'tencent/hy4-flash', prompt: ... }) con AI_GATEWAY_API_KEY configurada en el servidor. No pegues la clave en el navegador. Si tu aplicación necesita JSON validado, comprueba que cada salida se pueda parsear y que los valores pertenezcan al conjunto permitido antes de usarla. El soporte anunciado para salidas estructuradas no elimina la necesidad de validar en tu código.
Registra por mensaje si acertó la categoría, si marcó una urgencia falsa, si inventó hechos y si el JSON fue válido. En el panel de AI Gateway, la vista Logs muestra tokens, costo y duración por petición. Compara el costo por mensaje clasificado correctamente, no solo la tarifa por token: un modelo barato que exige revisar o repetir muchas salidas puede resultar caro en tiempo humano.
El límite de la noticia
Un cálculo puramente ilustrativo con la tarifa mostrada: 100.000 tokens de entrada y 20.000 de salida sumarían US$0,0068 antes de cualquier matiz de caché, promoción o facturación. No es una medición de un trabajo real. Tampoco significa que Hy4 Flash sea mejor o más rápido para tu caso que Qwen4-Max, Gemini u otro modelo. Prueba el mismo conjunto y observa errores y latencia en tu entorno.
Verificación de SoyJB: comprobamos la ficha de Vercel, identificador, fecha, precio visible, acceso y límites; no hicimos llamadas facturadas al modelo ni probamos la calidad de clasificación. Si procesas mensajes de clientes, revisa las condiciones de datos del proveedor antes de enviar información personal. Mantén aprobación humana para respuestas externas.
Fuentes: Vercel AI Gateway: ficha de Hy4 Flash; Vercel: Logs por petición; Tencent: recursos de identidad visual consultados para la portada.