Tu agente construye una app en minutos, pero al tercer cambio rompe la pantalla anterior. La reacción habitual es darle más autonomía o un modelo más caro. Anton Osika, cofundador de Lovable, contó el 4 de noviembre de 2026 algo menos intuitivo: en una etapa quitaron casi todo el código del agente abierto y volvieron a un flujo más predecible. Su historia ayuda a decidir qué mejorar primero si estás creando un producto con IA, pero no convierte el éxito de Lovable en una receta universal.
Qué contó Lovable
En su relato técnico oficial, Osika dice que la empresa acumuló más de 100.000 pull requests y que usuarios crearon más de 70 millones de proyectos. Son cifras reportadas por Lovable, no mediciones nuestras. El punto interesante está en las decisiones de ingeniería: comenzaron con proyectos nuevos y un stack definido, en lugar de soportar cualquier código y entorno desde el primer día. Eso les permitió conocer el sistema donde corrían las apps y repetir correcciones útiles entre proyectos.
Cuando dieron mucha libertad a agentes que podían crear subtareas y delegar, según el autor, aumentaron callejones técnicos, errores y tiempos impredecibles. Retrocedieron a un pedido de usuario que producía una cadena acotada de herramientas y una vista previa para que la persona pudiera revisar. Más tarde, con mejores modelos y controles, reabrieron posibilidades. La inferencia para un fundador es que la autonomía debe crecer al ritmo de la capacidad de verificar, no por moda.
Un experimento pequeño para tu propio agente
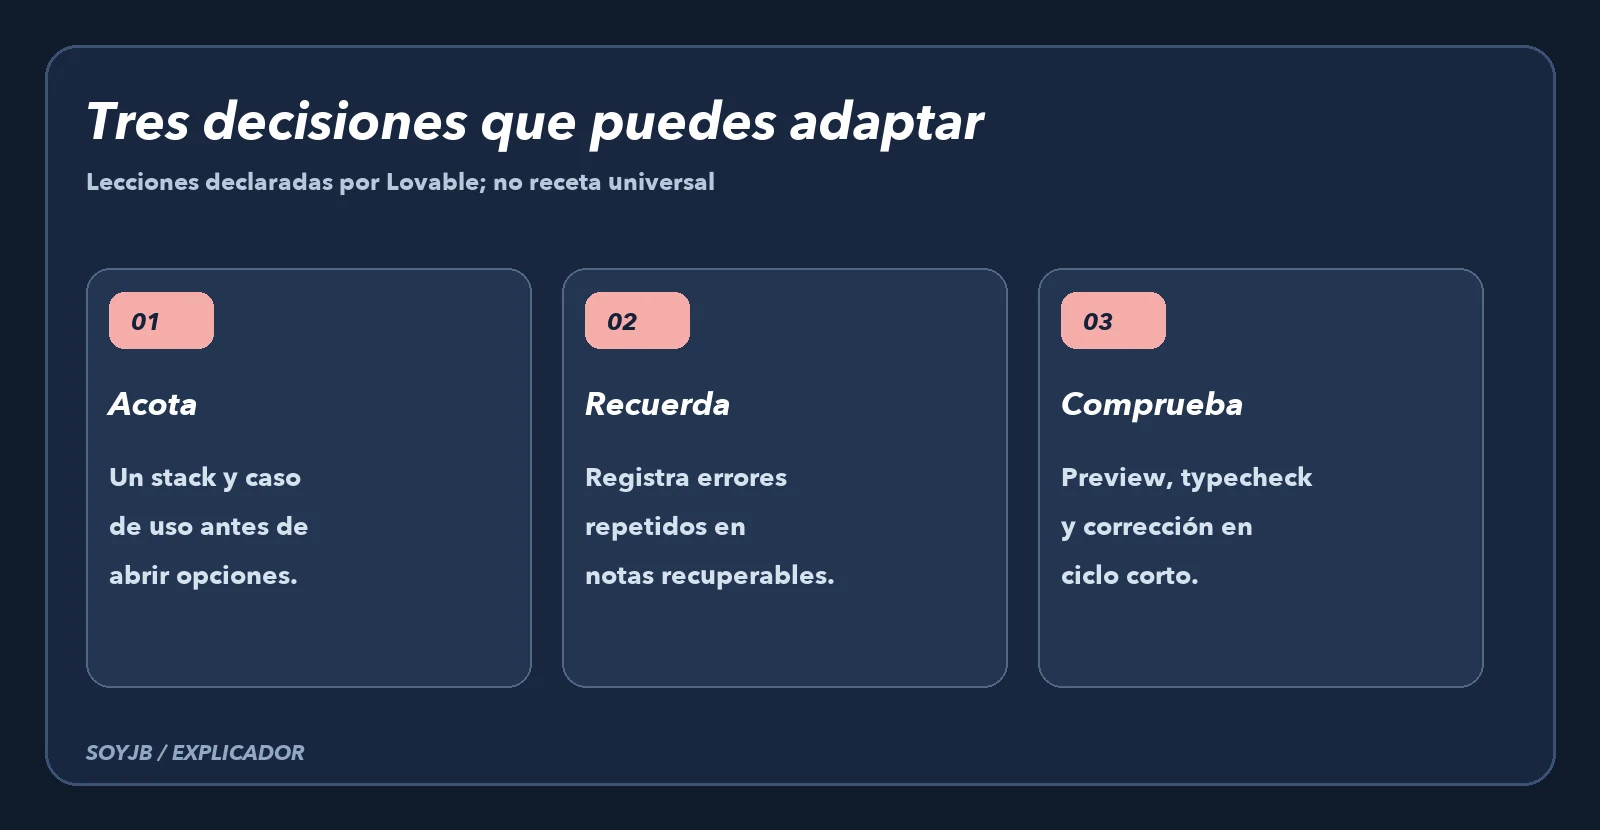
Elige una tarea donde tu producto falla repetidamente, por ejemplo «añadir un formulario con validación» en apps de un mismo stack. Durante una semana registra, para cada intento, el pedido, archivos tocados, error de build, corrección y resultado visible. No necesitas un sistema de evaluación enorme: diez casos bien clasificados pueden mostrar si el problema es contexto, libertad excesiva o falta de feedback.
Después crea una nota recuperable solo para el error frecuente, como esta:
# Formularios en el stack del producto
Antes de editar, localiza el componente y la validación ya usados en este repositorio.
No inventes nombres de componentes ni dependencias.
Tras el cambio, ejecuta typecheck y una prueba del estado inválido.
Si falla, informa el error exacto y corrige solo los archivos relacionados.
La vista previa y el diff deben quedar disponibles para revisión humana.
Compara cinco tareas nuevas con la nota y cinco sin ella, usando el mismo tipo de proyecto. Mide porcentaje que compila al primer intento, tiempo hasta una vista previa correcta, cambios no pedidos y número de intervenciones humanas. Si no mejora, revisa la selección de contexto o la definición de la tarea antes de acumular más instrucciones. Lovable cuenta que sus «knowledge files» eran notas breves de errores repetidos seleccionadas por recuperación; no eran simplemente un prompt gigantesco pegado siempre.
El feedback importa tanto como el modelo
Osika explica que mantuvieron sandboxes con archivos y servidor de desarrollo vivos, y usaron comprobaciones incrementales de TypeScript para devolver errores rápido al agente. También describe checkpoints de memoria, CPU y disco para recuperar entornos. Esa infraestructura no es algo que un fundador pequeño deba copiar entera. La pregunta útil es cuánto tarda tu ciclo editar → comprobar → corregir. Si cada cambio exige un build completo y quince minutos de espera, una mejora de modelo quizá no arregle la experiencia.
Prueba primero una vista previa estable, un typecheck rápido y un test que represente el fallo del usuario. Guarda las condiciones para reproducirlo y permite que una persona vea qué cambió. Aumenta autonomía únicamente cuando el agente demuestre que detecta y corrige ese tipo de error sin romper otra parte. Para datos y pagos, mantén validación humana y resguardos de producción aunque la demo parezca fluida.
Qué está verificado: las decisiones y cifras atribuidas a Lovable proceden del texto de Osika; el ejercicio de diez casos es una propuesta editorial de SoyJB, no un experimento realizado ni una métrica de Lovable. El valor para tu producto está en probar qué restricción o feedback reduce tus fallos reales.