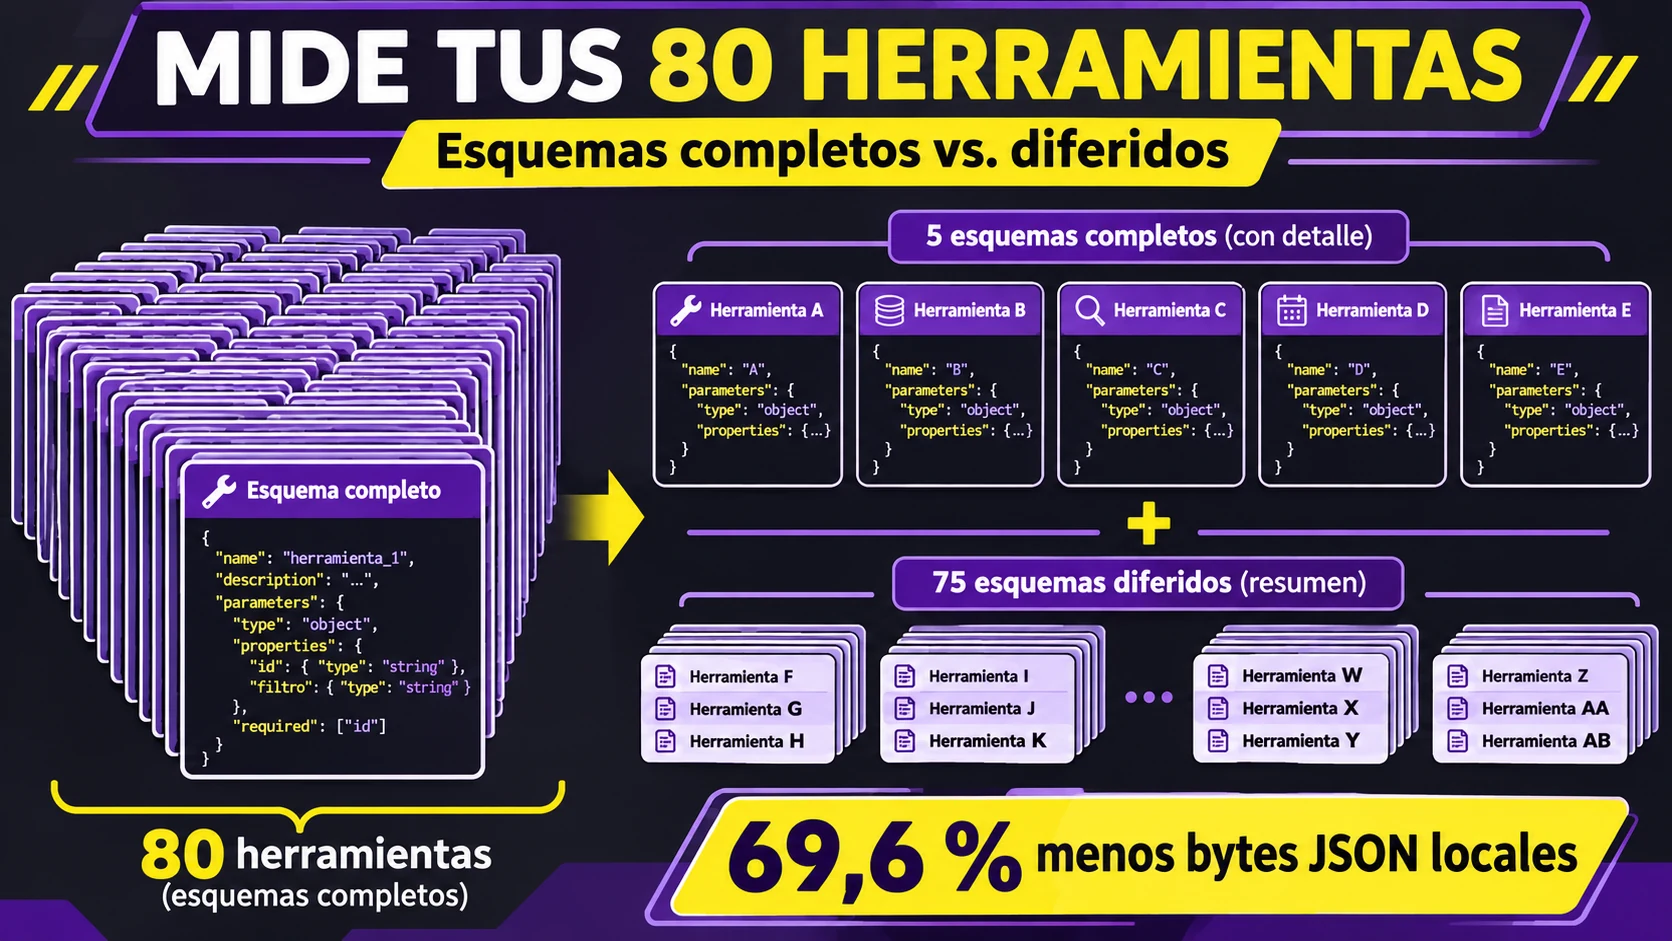
Tu agente tiene 80 funciones: buscar pedidos, consultar stock, enviar correos y más. Cada función trae un esquema de parámetros. Si envías todos los esquemas completos en cada petición, el contexto crece antes de que el usuario haga una sola pregunta. Google lanzó Tool Retrieval en vista previa el 19 de noviembre para Gemini Interactions API: el modelo ve el nombre y la descripción de las herramientas diferidas, y carga el esquema detallado solo cuando necesita una. Antes de activar esa función, puedes medir cuánto pesa tu catálogo.
Una medida local, con límites claros
El experimento siguiente genera 80 funciones ficticias de tamaño parecido. Compara dos representaciones JSON: todas completas frente a cinco completas y 75 con solo nombre, tipo y descripción. Eso aproxima la diferencia de datos que interesa al diseñar el catálogo. No cuenta tokens de Gemini, no mide latencia y no predice una factura. La API puede serializar internamente las herramientas de otra manera.
La decisión práctica es identificar si tus esquemas son lo bastante grandes para justificar una prueba con Tool Retrieval. Si casi todo el peso está en las descripciones y no en los parámetros, diferir quizá aporte poco. Si el peso cae mucho, vale la pena comparar solicitudes reales con y sin diferimiento cuando tengas acceso a la API.
Script reproducible
Guarda como schema_size.py y ejecuta python3 schema_size.py. No requiere claves ni red:
import json

def tool(number):
    return {
        "type": "function",
        "name": f"lookup_record_{number:02d}",
        "description": f"Look up a permitted business record in category {number:02d}.",
        "parameters": {
            "type": "object",
            "properties": {
                "record_id": {"type": "string", "description": "Business record ID"},
                "tenant_id": {"type": "string", "description": "Tenant ID"},
                "include_history": {"type": "boolean", "description": "Include changes"},
                "limit": {"type": "integer", "description": "Maximum rows"},
            },
            "required": ["record_id", "tenant_id"],
        },
    }

def size(value):
    return len(json.dumps(value, ensure_ascii=False,
                          separators=(",", ":")).encode())

full = [tool(i) for i in range(80)]
deferred = [
    item if i < 5 else {k: v for k, v in item.items()
                        if k != "parameters"}
    for i, item in enumerate(full)
]
a, b = size(full), size(deferred)
print(a, b, a - b, round((1 - b / a) * 100, 1))
assert len(full) == len(deferred) == 80
En mi equipo, la versión completa de la muestra ocupó 35.441 bytes y la versión con cinco esquemas completos ocupó 10.766: 24.675 bytes menos, una reducción local de 69,6 %. Es una muestra sintética diseñada para explicar el método, no una medición de tu agente. El código visible conserva las mismas estructuras y textos del script ejecutado. Tus esquemas darán otro resultado; registra también su porcentaje de reducción.
Adáptalo a tu catálogo real
- Exporta la definición de tus herramientas a JSON en un entorno de desarrollo. Elimina secretos y datos de clientes antes de guardar el archivo.
- Cuenta cuántas llamadas usan cada herramienta en un periodo definido, por ejemplo siete días. Conserva cargadas las cinco más frecuentes y simula el resto con nombre y descripción.
- Mide bytes de ambas representaciones, usando la misma serialización. Registra número de funciones, longitud media de descripción y porcentaje de reducción.
- En una prueba real de Gemini, compara además tokens reportados, latencia, selección correcta de herramienta y número de búsquedas internas. No uses una reducción local de bytes como sustituto de esos datos.
Google indica que se activa con una herramienta tool_search y defer_loading: true en las funciones elegidas. La búsqueda gestionada ocurre dentro de una petición; también existe búsqueda del lado del cliente para catálogos con permisos propios, que añade una ida y vuelta. El anuncio recomienda mantener las funciones más usadas sin diferir. El soporte es para Gemini 3.6 o posterior en Interactions API, en vista previa. Si tu agente depende de filtros por usuario, aplica autorización en el servidor aunque la búsqueda encuentre una herramienta.
Cuándo pasar a producción
Un resultado prometedor sería menos tokens de entrada y latencia aceptable sin empeorar la selección en un conjunto de tareas representativas. Un resultado negativo sería una herramienta equivocada o más búsquedas de las esperadas, aun si baja el tamaño inicial. No he probado la API de Gemini ni su coste con una cuenta real para este artículo; la única prueba propia es el script local de bytes. El siguiente paso es repetir la comparación con 20 tareas reales, revisión humana y un límite de gasto.