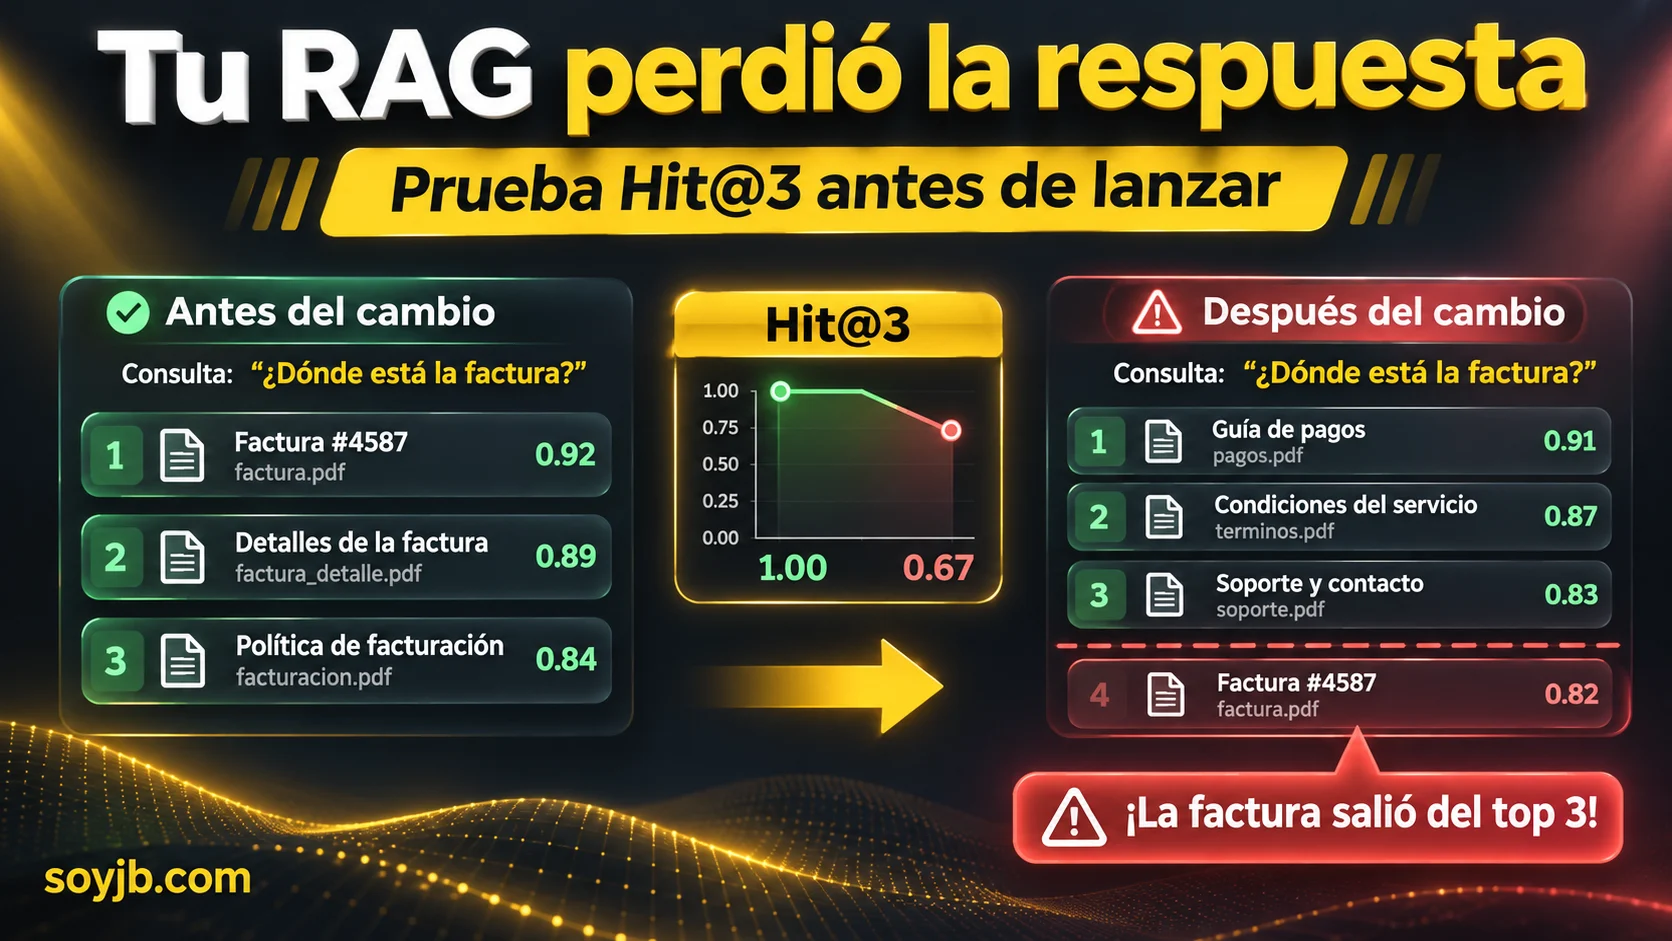
Tu app responde «no encontré la factura» aunque el documento sí está en la base. El endpoint de embeddings funciona, la búsqueda devuelve tres resultados y el chat contesta con seguridad. El problema está antes de la respuesta: el documento correcto dejó de aparecer entre los primeros resultados. Si cambiaste de modelo, índice, fragmentación o filtro, necesitas medir esta regresión antes de publicarla.
Esta prueba usa tres preguntas de soporte y un archivo JSON. No requiere una clave de IA: tú aportas los IDs reales que devolvió tu buscador antes y después. El script comprueba si el documento esperado aparece entre los tres primeros, muestra el resultado agregado y termina con código de error si una búsqueda que antes acertaba ahora falla.
Prepara casos que representen a tus usuarios
Elige preguntas que una persona realmente haría: cancelar una suscripción, descargar una factura y saber cuándo termina una prueba. Para cada una, identifica manualmente el documento que debe aparecer. Guarda el ID estable del documento o fragmento, no el texto generado por el LLM. La salida del modelo puede sonar convincente aunque haya recuperado la fuente equivocada.
El servicio de evaluaciones de Google define docRecall@k como la fracción de documentos relevantes recuperados entre los primeros k. Aquí usamos una medida aún más simple: Hit@3, que solo pregunta si un documento esperado aparece en los tres primeros. Es suficiente para detectar una pérdida evidente, pero no evalúa la calidad de la respuesta final ni sustituye una evaluación con múltiples documentos relevantes.
Crea cases.json con el formato siguiente. Los datos son inventados para mostrar una regresión reproducible:
[
  {"query":"¿Cómo cancelo mi suscripción?","expected":"cancel-policy",
   "before":["billing","cancel-policy","refunds"],
   "after":["cancel-policy","billing","refunds"]},
  {"query":"¿Puedo descargar una factura?","expected":"invoices",
   "before":["pricing","invoices","tax"],
   "after":["pricing","tax","receipts"]},
  {"query":"¿Qué pasa al terminar la prueba?","expected":"trial-expiry",
   "before":["trial-expiry","plans","billing"],
   "after":["plans","trial-expiry","billing"]}
]
before y after son los IDs en el orden devuelto por tu sistema. Mantén igual la pregunta, los filtros, el corpus y el valor de k al comparar. Si también cambias los datos, ya no sabrás qué causó la diferencia.
Para llenar el archivo en una app real, llama directamente a tu función de búsqueda y registra los tres primeros IDs antes de desplegar el cambio. Repite la misma consulta contra la versión candidata. Si tu app solo expone la respuesta del chat, añade temporalmente un registro de los IDs recuperados o una vista de diagnóstico privada. No copies datos personales ni documentos completos al archivo de prueba: basta con identificadores estables y preguntas anonimizadas. Guarda el conjunto bajo control de versiones para que el siguiente cambio se compare con la misma referencia.
Ejecuta una prueba que pueda bloquear el despliegue
Guarda este script como check_retrieval.py. Usa solo Python estándar:
import json, sys

cases = json.load(open(sys.argv[1], encoding="utf-8"))
if not cases:
    raise SystemExit("No hay casos")

before_hits = after_hits = 0
regressions = []
for case in cases:
    before = case["expected"] in case["before"][:3]
    after = case["expected"] in case["after"][:3]
    before_hits += before
    after_hits += after
    if before and not after:
        regressions.append(case["query"])

n = len(cases)
print(f"Hit@3 antes: {before_hits}/{n} ({before_hits/n:.0%})")
print(f"Hit@3 después: {after_hits}/{n} ({after_hits/n:.0%})")
for query in regressions:
    print(f"REGRESIÓN: {query}")
sys.exit(1 if regressions else 0)
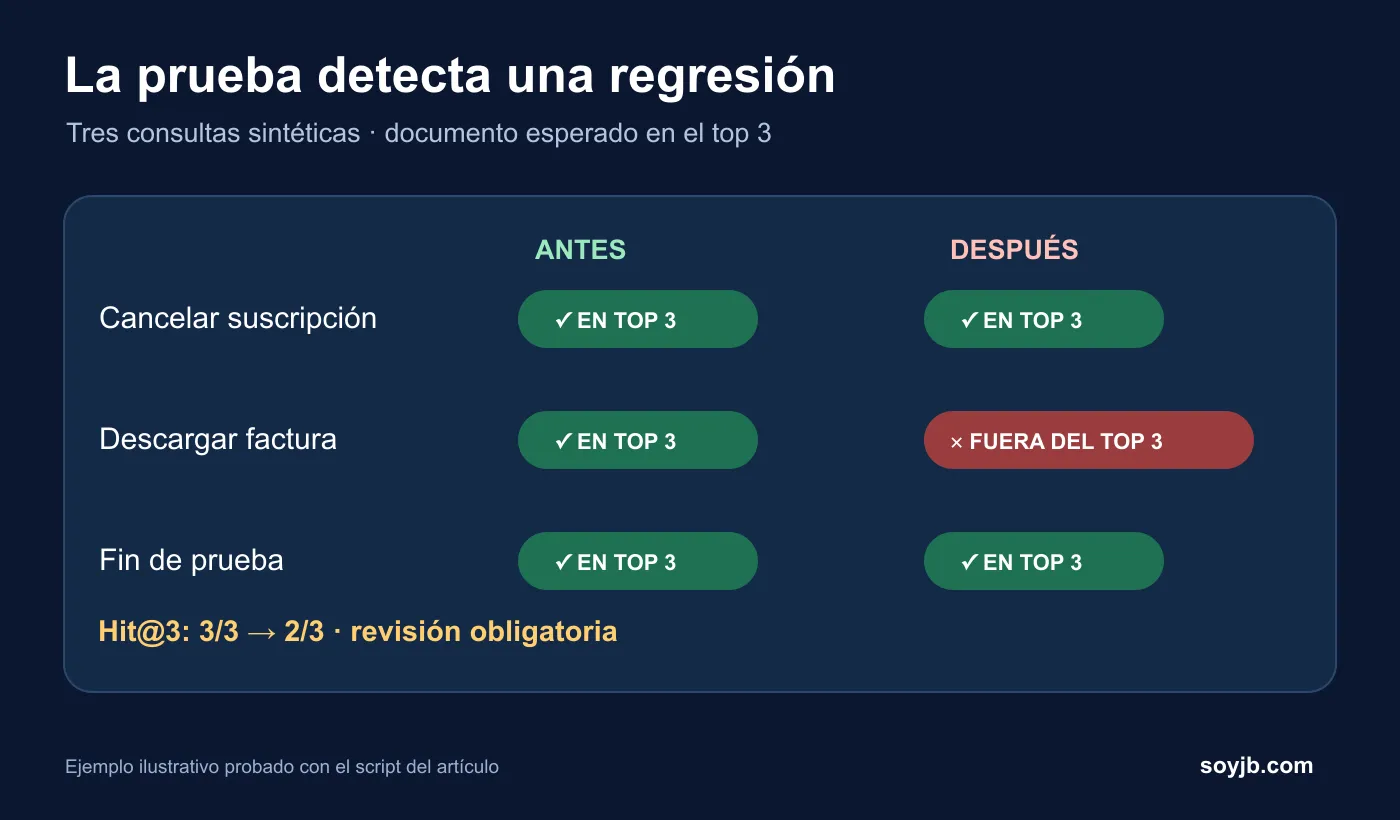
Ejecuta python3 check_retrieval.py cases.json. Con el ejemplo, el resultado es 3/3 antes, 2/3 después y una regresión en facturas; el proceso termina con estado 1. Probé el mismo criterio con ese conjunto sintético. No he probado tu índice ni afirmo que la cifra describa un producto real.
Qué hacer cuando falla
- Abre la pregunta fallida y mira los documentos que desplazaron al esperado. Comprueba filtros, permisos, idioma y si el documento sigue en el corpus.
- Si cambiaste de embeddings, verifica que consulta e índice usen espacios compatibles. Google distingue claramente entre pasar de Embedding 2 Preview al estable, que no requiere reindexar, y pasar de Embedding 001 a Embedding 2, que sí requiere regenerar vectores.
- Si el vector es correcto, revisa fragmentación, metadatos, ranking y el valor de
top_k. Cambia una variable cada vez y repite el mismo archivo de casos.
Empieza con cinco a diez consultas reales para encontrar fallos obvios; amplía después a casos de distintos temas, idiomas y permisos. Mantén un conjunto aparte que no uses para ajustar el ranking, para no optimizar solo tus ejemplos conocidos. Un 100% sobre tres preguntas de juguete no certifica una búsqueda excelente; una caída sobre una pregunta crítica sí merece investigación.
También registra la posición del documento esperado, no solo si aparece. Pasar del primer resultado al tercero conserva el Hit@3, pero puede reducir la probabilidad de que el generador lo use. Después de aprobar la recuperación, evalúa por separado si la respuesta cita la fuente correcta y si omite información que no está en el documento. Son dos fallos distintos y merecen controles distintos.