Un fundador calcula que su asistente costará USD 100 al mes porque multiplica 100.000 conversaciones por el precio de los tokens de entrada. Luego llega la factura: el modelo también cobra la salida, algunas llamadas usan herramientas y la caché no se aplica a todos los tokens. El error no está en la multiplicación; está en medir solo una parte de cada petición.
Esta guía construye una estimación reproducible con cuatro datos observados por llamada: entrada sin caché, entrada leída de caché, salida y cargos adicionales. El ejemplo es hipotético; cambia los números por los de tus registros y las tarifas vigentes del proveedor antes de tomar una decisión de producto.
Empieza con una conversación representativa
Elige una función concreta, por ejemplo un bot que responde preguntas sobre pedidos. Registra 50–100 solicitudes reales o de una prueba interna con la misma configuración que piensas desplegar. No calcules tokens contando caracteres: usa los campos de uso de la API. Distingue una respuesta corta de una conversación larga y registra también percentiles, no solo promedios. Unos pocos casos extensos pueden dominar el gasto.
El comparador de APIs de SoyJB sirve para escoger candidatos y simular entrada y salida con precios de lista. Su propia página advierte que esa simulación no incorpora caché ni batch. Para presupuestar una app real, añade lo que efectivamente utiliza tu flujo: lecturas y escrituras de caché, llamadas a herramientas, búsquedas, almacenamiento o ejecución, según el proveedor.
La fórmula que debes separar
Para una llamada: (entrada_sin_cache × tarifa_entrada + entrada_cacheada × tarifa_cache + salida × tarifa_salida) / 1_000_000 + extras. Multiplica por el número mensual de llamadas. Las tarifas son dólares por millón de tokens; extras es el costo adicional promedio por llamada, medido o estimado por separado.
No cuentes dos veces la caché. En la documentación de uso de OpenAI, los tokens cacheados están incluidos en el total de entrada. Para esta fórmula, resta los cacheados y usa el resto como entrada sin caché. Revisa el desglose equivalente del proveedor que usas. Además, la caché puede tener cargo de escritura: OpenAI y Anthropic publican categorías de lectura y escritura distintas. Registra esas escrituras dentro de extras si el modelo y la configuración las cobran.
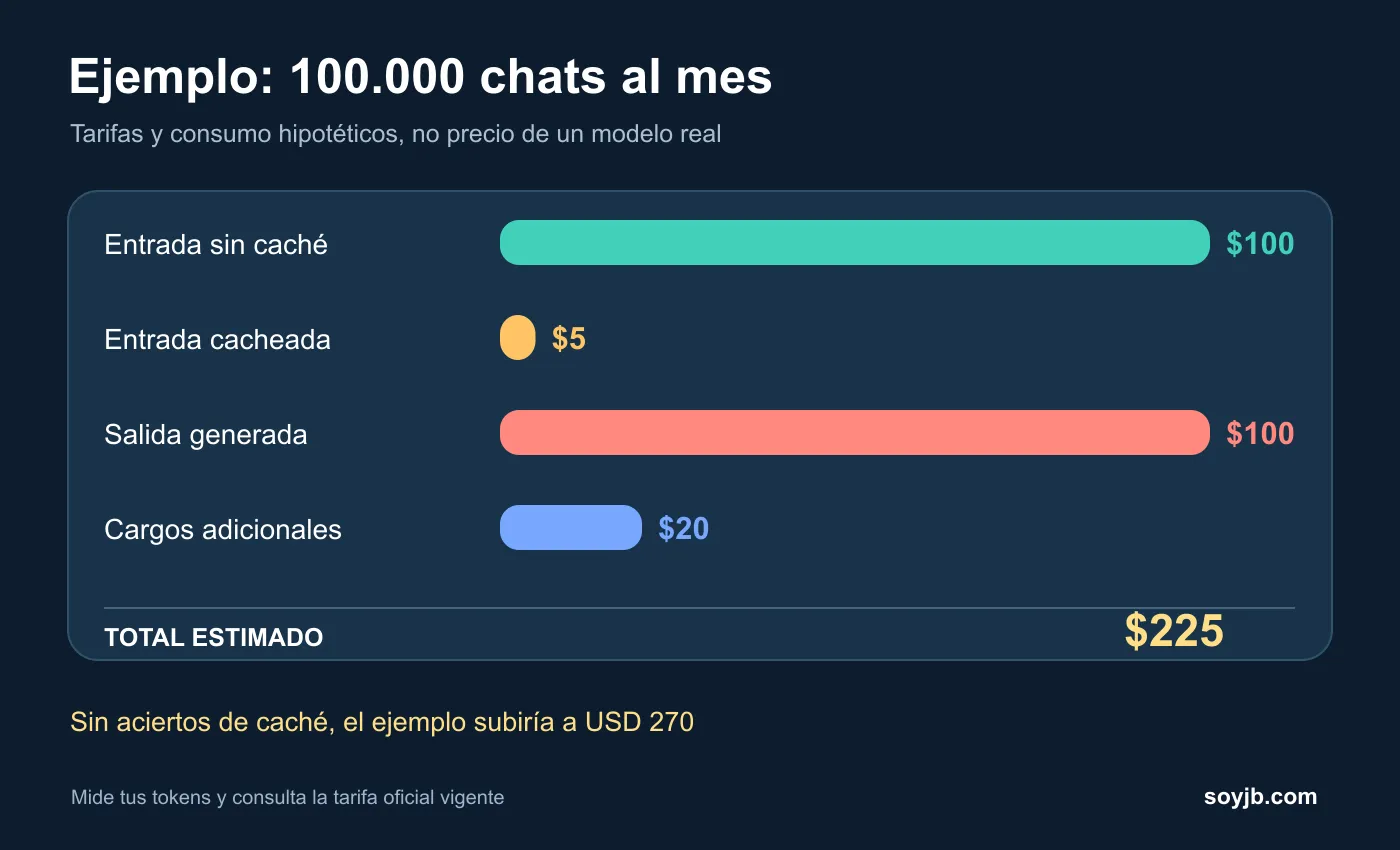
El ejemplo siguiente usa tarifas inventadas para enseñar el cálculo: USD 1 por millón de entrada, USD 0,10 por millón de entrada cacheada y USD 5 por millón de salida. No representan un modelo específico ni una cotización actual.
from decimal import Decimal as D

def estimate(calls, uncached_in, cached_in, output,
             rate_in, rate_cached, rate_out, extras_per_call=0):
    million = D(1_000_000)
    per_call = (
        D(str(uncached_in)) * D(str(rate_in)) / million
        + D(str(cached_in)) * D(str(rate_cached)) / million
        + D(str(output)) * D(str(rate_out)) / million
        + D(str(extras_per_call))
    )
    return per_call, per_call * D(str(calls))

per_call, monthly = estimate(
    calls=100_000, uncached_in=1_000, cached_in=500,
    output=200, rate_in=1, rate_cached=0.10,
    rate_out=5, extras_per_call=0.0002,
)
print(f"Por llamada: ${per_call:.6f}")
print(f"Por mes: ${monthly:.2f}")
La salida del ejemplo es Por llamada: $0.002250 y Por mes: $225.00. Probé este cálculo localmente con los números sintéticos. De ese total, USD 100 provienen de la entrada sin caché, USD 5 de lecturas cacheadas, USD 100 de la salida y USD 20 de los cargos adicionales. Si los 500 tokens cacheados se cobraran como entrada normal, la estimación subiría a USD 270; el ahorro hipotético sería USD 45. La caché solo produce ese ahorro si realmente hay aciertos y si incluiste su costo de escritura.
Cómo usarlo para decidir qué modelo lanzar
- Prueba el mismo conjunto de preguntas en dos o tres modelos. Guarda uso de tokens, calidad de respuesta, tiempo de respuesta y frecuencia de herramientas. Un modelo barato por token puede emitir más tokens o necesitar más reintentos.
- Toma la tarifa actual de la tabla oficial de OpenAI, la de Anthropic o la de Gemini, según corresponda. Confirma modalidad, nivel de procesamiento y región: pueden cambiar el precio.
- Calcula escenario bajo, típico y alto. Aumenta las llamadas y la longitud de salida según tu producto; añade margen para reintentos y picos de demanda. Compara el costo con el valor que produce cada conversación, no solo con otra API.
Esta cuenta es un presupuesto operativo, no una factura exacta. La facturación real depende de métricas de uso, precio contratado, modalidad, descuentos, caché, herramientas y posibles cambios de tarifa. Reconcíliala con la factura del proveedor durante la primera semana y ajusta el modelo antes de escalar.