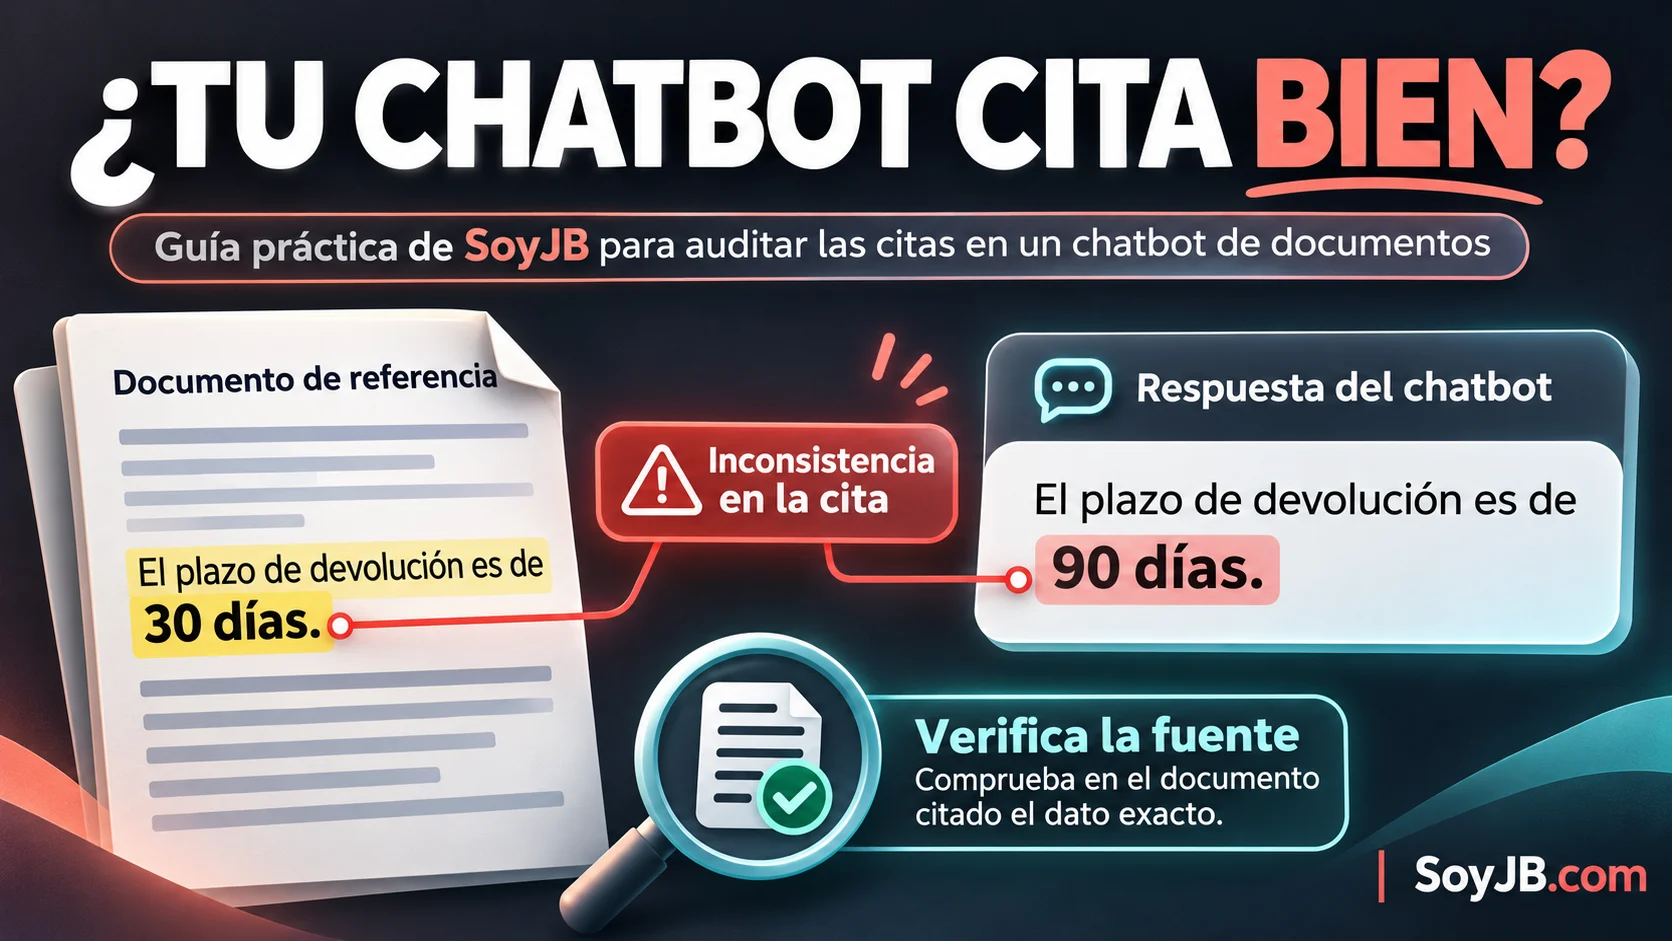
Tu buscador de documentos encuentra la página correcta y supera una prueba de recuperación. Sin embargo, el chatbot responde que los archivos se guardan 90 días cuando la política dice 30. El enlace que muestra es real; la afirmación no está respaldada por ese enlace. Si vas a poner un asistente delante de clientes o empleados, necesitas revisar la respuesta después de la búsqueda. Esta guía es el paso siguiente a medir Hit@3 en la recuperación.
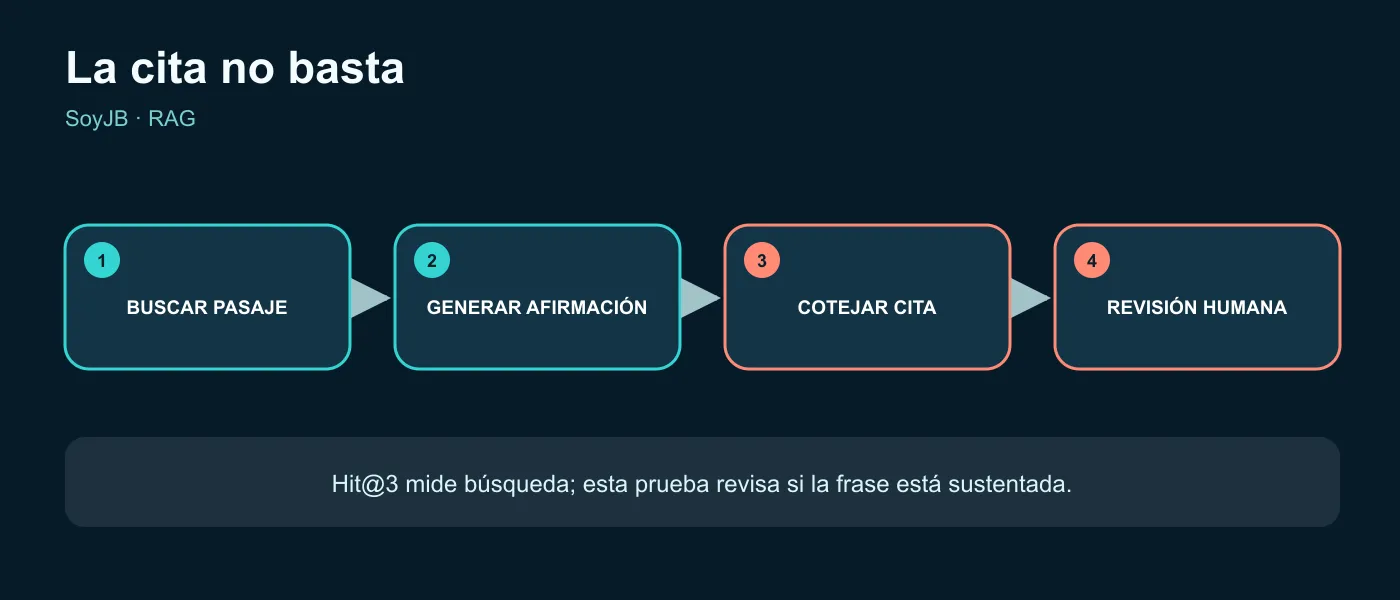
Dos pruebas que no debes mezclar
Hit@3 pregunta si el documento correcto apareció entre los tres primeros resultados. La auditoría de citas pregunta si cada afirmación concreta de la respuesta está apoyada por el fragmento citado. Puedes aprobar la primera y fallar la segunda. Google Cloud documenta esta idea como comprobar si una respuesta candidata está fundamentada en textos de referencia; incluso una frase parcialmente correcta puede quedar sin sustento. Para una app pequeña, empieza con una batería manual y un control automático muy acotado.
Construye cinco preguntas reales, anonimizadas. Incluye una cuya respuesta esté en el documento, otra con dos documentos que se contradigan, una que requiera fecha, una que no tenga respuesta y una con una frase parecida pero incorrecta. Guarda el conjunto de fragmentos recuperados, la respuesta, sus citas y la versión del prompt. Si cambia el índice o el modelo, vuelve a ejecutar exactamente los mismos casos.
Exige citas por afirmación y permiso para decir «no sé»
Prueba este prompt en el paso de generación, después de recuperar documentos. Cambia el formato al de tu aplicación, pero mantén el contrato:
Responde solo con los fragmentos recuperados abajo.
Para cada afirmación verificable, cita ID de fuente y una frase textual
breve que la respalde. No cites una fuente que no esté en el contexto.
Si los fragmentos se contradicen, explica el conflicto y sus fechas.
Si no hay soporte suficiente, di «No encuentro la respuesta en estas
fuentes» y sugiere qué dato falta. No inventes políticas, precios o plazos.
Devuelve: respuesta, lista de afirmaciones (texto, fuente, cita), dudas.
El evaluador humano marca por separado: fuente existente, cita textual presente, apoyo semántico de la afirmación, actualidad de la fuente y conducta de abstención. Una cita puede ser textual y aun así no demostrar lo que afirma el modelo; por ejemplo, «hasta 10 proyectos» no demuestra «10 proyectos gratis». Por eso el control de cadena que sigue es un filtro de formato, no un detector completo de alucinaciones.
Filtro mínimo ejecutable
Este ejemplo es completamente ficticio. Guárdalo como citation_check.py y ejecútalo con Python estándar. Verifica que cada ID exista y que la frase citada aparezca literalmente en su fuente. Lo probé con los datos de muestra:
sources = {
    "S1": "El plan Pro permite hasta 10 proyectos activos.",
    "S2": "Los archivos se conservan durante 30 dias.",
}
claims = [
    {"text": "El plan Pro permite 10 proyectos.", "source": "S1", "quote": "hasta 10 proyectos activos"},
    {"text": "Los archivos duran 90 dias.", "source": "S2", "quote": "90 dias"},
]
for index, claim in enumerate(claims, 1):
    source = sources.get(claim["source"])
    print(index, "QUOTE_FOUND" if source and claim["quote"] in source else "REVIEW")
La salida esperada es 1 QUOTE_FOUND y 2 REVIEW. El segundo caso inventa 90 días y su cita no existe. Pero QUOTE_FOUND no equivale a «respuesta correcta»: solo dice que el texto citado aparece en la fuente. Mantén revisión humana de una muestra y todos los casos de alto impacto.
Para evitar falsos «aprobado», registra cada afirmación como unidad separada. Una frase con dos números necesita respaldo para ambos. Si el documento tiene versiones, guarda su fecha junto al ID: una cita auténtica de una política vencida también puede inducir una decisión equivocada. En casos contradictorios, espera que el bot muestre las dos fuentes y no elija silenciosamente una. Y cuando una pregunta no aparece en ninguna fuente, una abstención clara es un resultado exitoso; no la cuentes como fallo por no producir respuesta. Estas decisiones vuelven la prueba útil para el producto, no solo para el formato.
Decisión antes del lanzamiento
Para una versión inicial, puedes exigir cero citas inexistentes en el conjunto crítico, abstención correcta cuando no hay soporte y una revisión humana de todas las afirmaciones sobre precio, política o datos sensibles. Si el bot falla, identifica dónde: búsqueda, documento obsoleto, prompt o generación. Añadir más enlaces sin revisar el apoyo de cada frase no arregla el problema. Registra fallos reales para ampliar la batería y compara versiones con la misma distribución de preguntas.
Fuentes: Google Cloud, Check grounding with RAG; OpenAI, evaluation best practices. El ejemplo de política y los resultados son sintéticos; el script no llama a ninguna API ni comprueba equivalencia semántica.