Tu agente de código puede arreglar una pantalla sencilla o perseguir un fallo que cruza la API, la base de datos y el frontend. No conviene elegir el mismo modelo por costumbre para ambos trabajos. OpenAI anunció el 17 de noviembre de 2026 GPT‑6.2 Sol y GPT‑6.2 Astra para Codex, ChatGPT Work y la API. La decisión útil para un vibecoder o fundador es medir cuándo Sol resuelve el trabajo cotidiano y cuándo el problema justifica subir a Astra.
Qué cambió hoy
Sol es la opción de uso diario para escribir, revisar y modificar código en varios pasos. Astra se orienta a tareas más complejas: seguir un error entre servicios, cambiar una base de código existente y comprobar el resultado. Esas descripciones son del fabricante, no resultados medidos por SoyJB. Los identificadores de API son gpt-6.2-sol y gpt-6.2-astra. Ambos admiten entrada de texto e imagen y salida de texto; no son modelos de generación de audio o video.
En Codex puedes elegirlos desde el selector o con /model en la CLI. La guía oficial también muestra codex -m gpt-6.2-sol y codex -m gpt-6.2-astra. En Work aparecen según plan y cliente; Enterprise y Edu requieren que el administrador habilite los modelos. En la API están disponibles mediante Responses y Chat Completions, pero las llamadas a herramientas requieren Responses. No he ejecutado una prueba en la cuenta de Joseph ni una petición facturada a la API.
Precio: compara la tarea completa
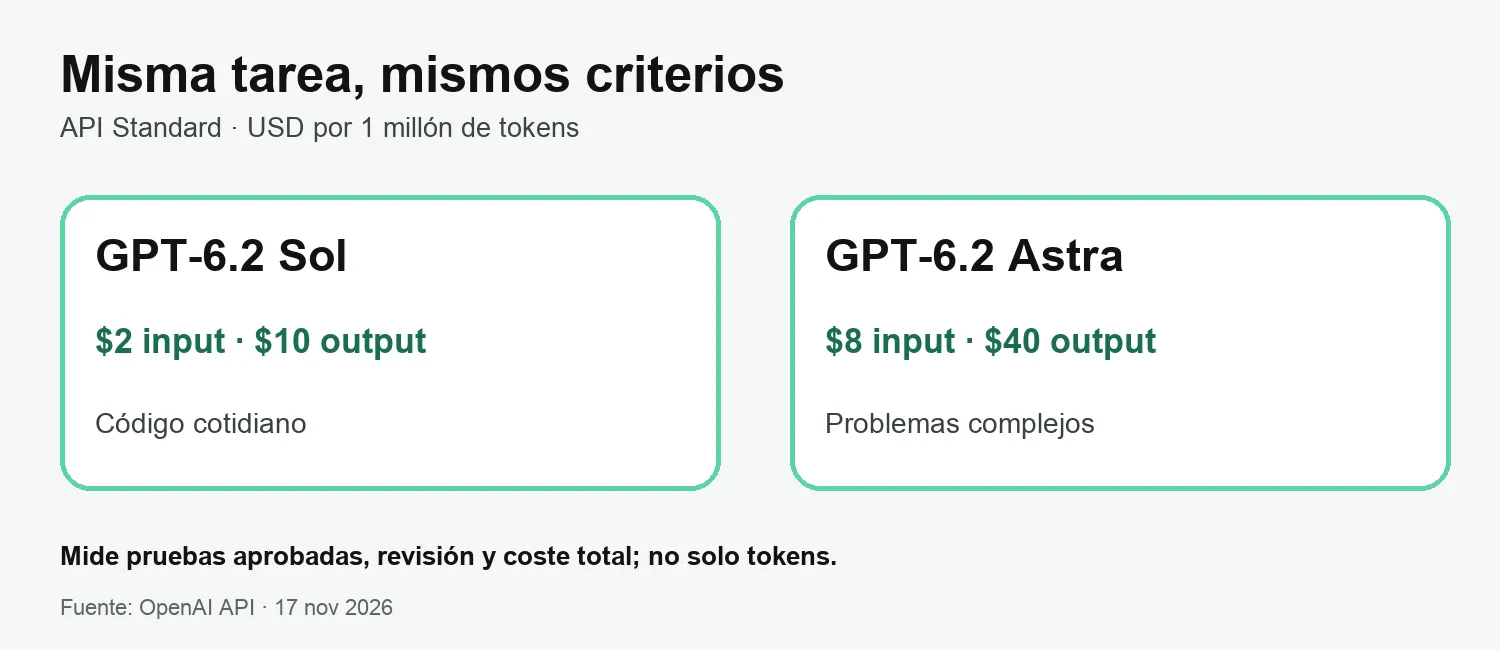
En la API, tarifa Standard para solicitudes cortas, Sol cuesta $2 por millón de tokens de entrada y $10 por millón de salida. Astra cuesta $8 de entrada y $40 de salida. Son precios por tokens de API, no el coste de créditos de tu suscripción a Work o Codex. La entrada en caché, la escritura de caché, el nivel de servicio y las solicitudes largas tienen tarifas distintas. Si una solicitud supera 272.000 tokens de entrada, el precio de entrada y caché se duplica y el de salida pasa a 1,5 veces la tarifa corta para toda la solicitud, según las fichas oficiales. Por eso un contexto gigantesco puede cambiar el presupuesto de la prueba.
Una estimación ilustrativa con 10.000 tokens de entrada y 2.000 de salida, sin caché ni herramientas facturadas, sería $0,04 en Sol y $0,16 en Astra. Es aritmética sobre la tarifa publicada, no una factura real ni una predicción del consumo de un agente: una tarea puede requerir varias llamadas, herramientas y revisiones. El coste por tarea importa más que el precio por millón si un modelo evita retrabajo.
Prueba reproducible para tu repositorio
- Elige una incidencia real con criterio de aceptación observable. Ejemplo: «al guardar una nota, otro usuario no debe poder verla». Prepara una rama de prueba y los mismos archivos, instrucciones y permisos para ambos modelos.
- Empieza con Sol. Pide una propuesta, implementación y ejecución de las pruebas pertinentes. Conserva la salida, número de intentos, tiempo y consumo que muestre tu herramienta.
- Restablece la rama al mismo estado y repite con Astra. No permitas que vea la solución de Sol; así reduces la ventaja de información.
- Compara si cada versión pasa las mismas pruebas, si introduce una regresión, cuánto trabajo manual necesitas para aceptarla y el coste observado. Si ninguna pasa, registra el bloqueo en vez de declarar ganador.
Prompt copiable para las dos corridas:
Objetivo: corregir [fallo observable] en este repositorio.
Criterios de aceptación: [lista de comportamientos verificables].
Antes de editar, localiza la causa y explica tu hipótesis.
Haz el cambio mínimo, ejecuta las pruebas afectadas y
reporta: archivos tocados, comandos ejecutados, resultados,
riesgos pendientes y cualquier herramienta o archivo inaccesible.
No declares éxito si una prueba falla o no pudo ejecutarse.
Cómo decidir esta semana
Si Sol resuelve una tarea frecuente con las mismas pruebas y menos coste, úsalo como punto de partida. Si falla en un problema que atraviesa varios componentes, prueba Astra y compara el coste total del trabajo, incluida tu revisión. Para marketing o creación de contenido, usa una muestra real de briefs y evalúa exactitud, tono y edición necesaria; no traslades una conclusión de código a escritura sin medirla.
El anuncio no demuestra que Astra gane siempre ni que Sol sea suficiente para todos los MVP. OpenAI presenta evaluaciones propias y de terceros con metodologías distintas; el rendimiento en tu producto depende del contexto, las herramientas y los criterios de aceptación. Revisa también límites de tu cuenta, región y disponibilidad antes de prometer una función a clientes.