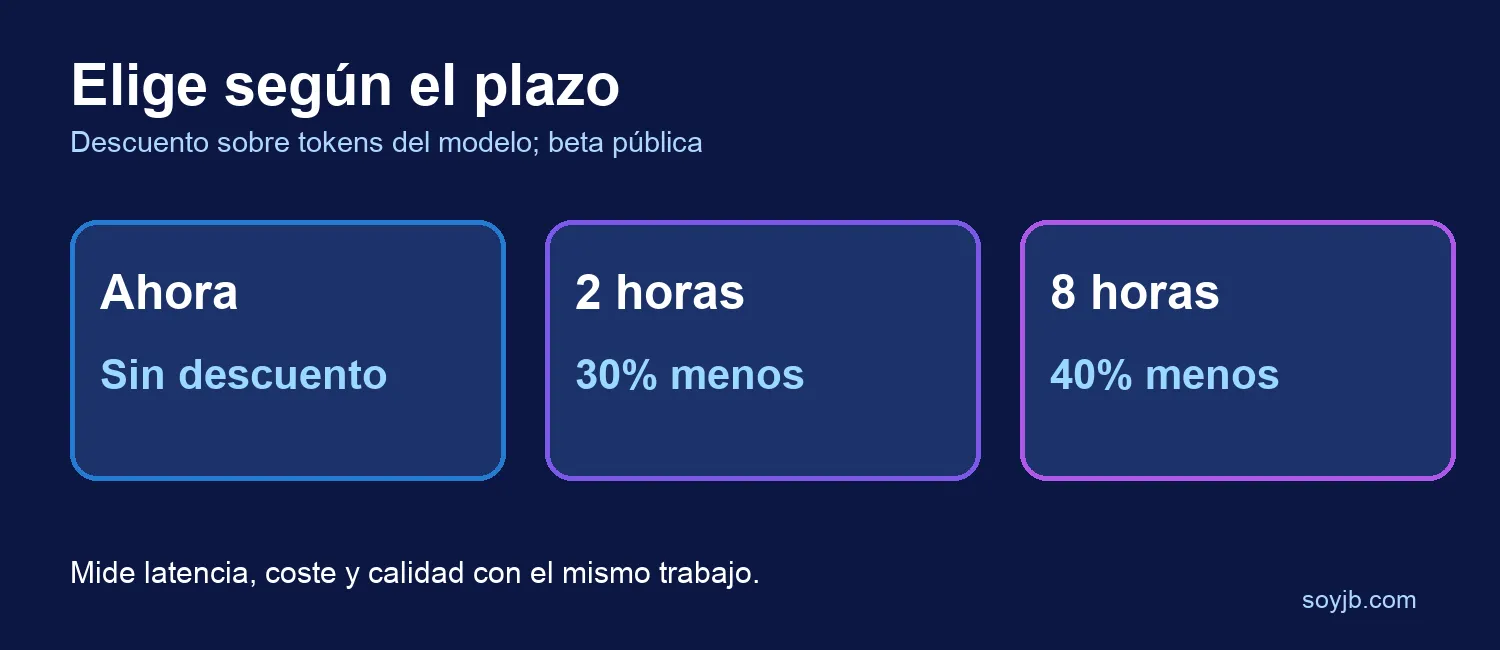
Un fundador que resume tickets de soporte cada mañana no necesita pagar por una respuesta inmediata si la revisión puede llegar antes de la reunión de la tarde. La documentación de OpenAI, consultada el 18 de noviembre de 2026, ofrece dos ventanas de finalización en segundo plano para Responses API: 2 horas con 30% de descuento y 8 horas con 40% frente a la tarifa Standard de tokens del modelo. Están en beta pública. La decisión práctica es separar trabajo urgente del que puede esperar, sin asumir que una ventana es una promesa de latencia exacta.
Qué cambia y quién puede usarlo
El modo background ya permitía enviar una solicitud, guardar su ID y recibir el resultado después. Ahora background_options.completion_window permite elegir 2h u 8h. OpenAI dice que apunta a completar la respuesta inicial dentro de la ventana desde que acepta la solicitud. La tarifa reducida aplica a los tokens del modelo de cada solicitud elegible, incluidos seguimientos que conserven la configuración; no significa 30% o 40% de ahorro sobre toda tu factura, que puede incluir otras herramientas y cargos.
La beta pública admite GPT‑6.2 Astra, GPT‑6.2 Sol, GPT‑6.1 Terra y GPT‑6 Luna. Requiere background: true, procesamiento Standard (service_tier: "default") y stream desactivado u omitido. Con service_tier: "auto", solo califica si la API elige Standard. Las ventanas de 2 y 8 horas comparten el límite de tokens en cola de Batch/Background; una organización con mucha carga puede encontrarse con ese límite antes de ahorrar.
Prueba reproducible: triage de tickets sin datos reales
Prepara tres tickets ficticios: un recibo duplicado, una invitación de equipo que no llega y una pregunta de factura. Pide una tabla con categoría, urgencia, evidencia faltante y una respuesta sugerida. Envía exactamente el mismo conjunto a Standard inmediato y a la ventana de 2 horas. Guarda ID, hora de aceptación, hora de finalización, tokens facturados y calidad de las clasificaciones. No metas mensajes de clientes reales hasta revisar tus reglas de privacidad.
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "service_tier": "default",
    "background": true,
    "background_options": {"completion_window": "2h"},
    "input": "Clasifica estos tickets ficticios por urgencia y explica por qué: recibo duplicado; invitación de equipo no recibida; pregunta sobre fecha de factura. Devuelve una tabla breve."
  }'
La respuesta inicial trae un ID. Guarda ese ID y espera un webhook response.completed con firma verificada, o consulta el estado por ID hasta que deje de estar queued o in_progress. Evita reintentar a ciegas: crear otra solicitud puede duplicar el trabajo y el coste. Si el resultado debe estar listo mañana, prueba 8h con un lote pequeño y mide el tiempo real antes de automatizarlo.
Cuándo conviene y dónde está el límite
Usa 2h para triage matinal que alimenta una reunión posterior; 8h para revisar documentos durante la noche. Usa la ruta inmediata si alguien espera frente a la pantalla. Para cientos de solicitudes independientes que puedes enviar juntas, compara también la Batch API: el modo de fondo es especialmente útil cuando una respuesta puede desencadenar una siguiente acción o herramienta.
Hay una condición de datos importante: OpenAI almacena temporalmente el contenido necesario para ejecutar y recuperar una respuesta en segundo plano, incluso con store: false o Zero Data Retention. También documenta cifrado en reposo de ese almacenamiento temporal. Revisa este comportamiento con tus políticas antes de enviar información sensible. Los límites, precios y modelos pueden cambiar durante la beta; verifica la página oficial al implementar. SoyJB revisó documentación y construyó el ejemplo, pero no ejecutó una llamada de pago ni midió tiempos reales.