Un deploy puede salir verde y romper la única ruta que convierte usuarios: por ejemplo, la API que muestra disponibilidad antes de pagar. Una prueba previa a compartir la app no detecta una caída que aparece después de publicar o cuando falla una dependencia. Este monitor mínimo ejecuta una petición real contra un endpoint público, exige HTTP 200 y una respuesta JSON con ok: true, y termina con código distinto de cero cuando algo falla. Lo probamos localmente; adaptarlo a producción requiere elegir una ruta y un sistema de alertas.
Define qué significa «funciona»
No basta con pedir la portada y ver un 200: un CDN puede entregar HTML mientras el flujo crítico está roto. Elige una ruta de lectura segura que represente una función importante. Para una app de reservas podría ser /api/availability-check con una cuenta o recurso de prueba. Debe devolver un JSON pequeño, sin datos sensibles, y no crear pedidos ni cobrar. Si necesita autenticación, usa un secreto de prueba guardado en el monitor, nunca en la URL ni en un artículo.
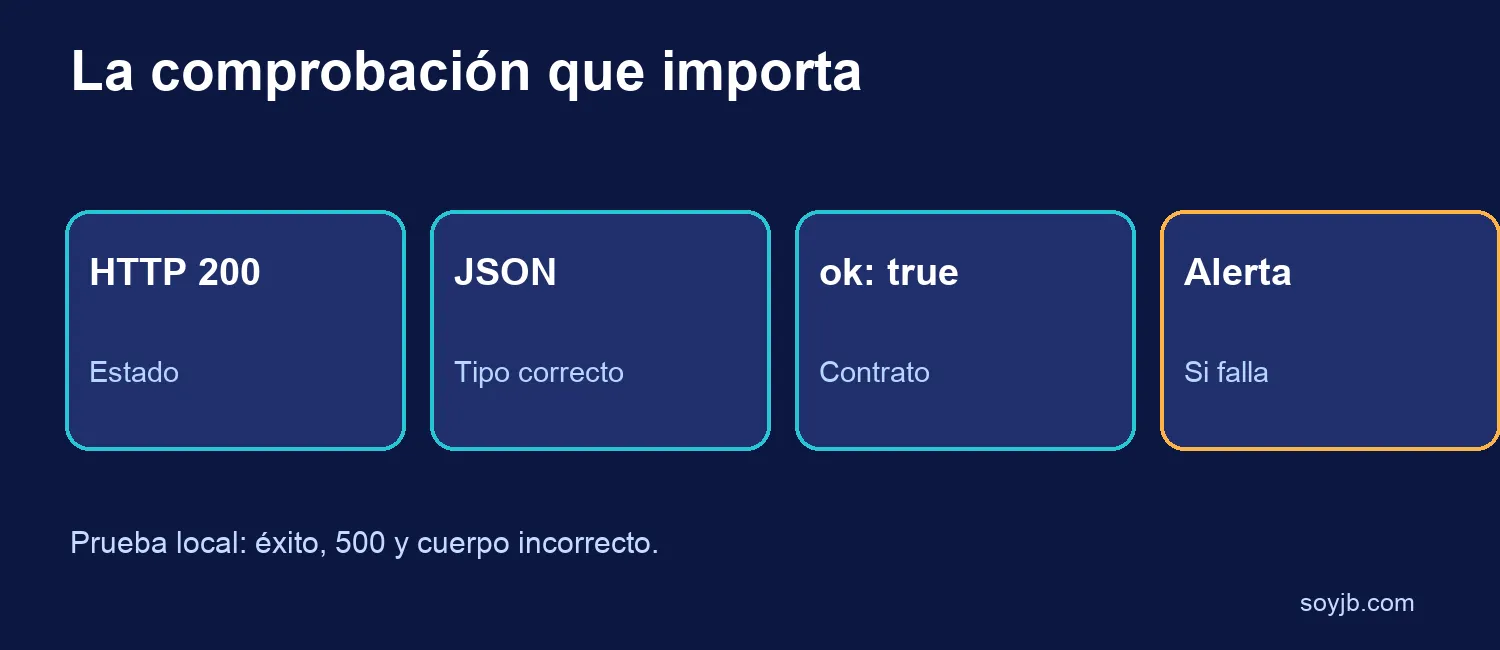
En este ejemplo, el contrato es deliberadamente simple: estado 200, Content-Type JSON y cuerpo {"ok":true}. Tu app debe ofrecer una ruta que cumpla ese contrato o debes ajustar la comprobación a su respuesta real. No conviertas un error interno en ok:true solo para que el monitor pase.
Script Node.js copiable
const url = process.env.CHECK_URL;
if (!url) throw new Error('Set CHECK_URL');

try {
  const response = await fetch(url, {
    signal: AbortSignal.timeout(5000),
    cache: 'no-store',
  });
  if (response.status !== 200) throw new Error(`HTTP ${response.status}`);
  if (!response.headers.get('content-type')?.includes('application/json')) {
    throw new Error('Expected JSON');
  }
  const body = await response.json();
  if (body.ok !== true) throw new Error('Expected ok=true');
  console.log('Critical endpoint OK');
} catch (error) {
  console.error(`Critical endpoint failed: ${error.message}`);
  process.exitCode = 1;
}
Guárdalo como check.mjs y ejecuta CHECK_URL=https://tu-dominio.example/api/health node check.mjs. El timeout de cinco segundos limita el tiempo de espera del monitor; no es una meta universal de rendimiento. El resultado debe alimentar una alerta real en tu proveedor de monitorización o CI, no quedarse en un log que nadie mira.
Qué probamos y qué falta
En Node.js 22.23.4 levantamos un servidor local efímero con tres respuestas: 200 con {"ok":true}, 500 con {"ok":false} y 200 con un cuerpo JSON incorrecto. La comprobación pasó el caso sano y rechazó los otros dos. No se probó una URL de producción, un sistema de alertas ni el caso de timeout en red real. Es una verificación del script, no un informe de disponibilidad.
Después de desplegar, ejecútalo una vez contra la nueva versión y conserva el resultado con el ID del deploy. Para vigilancia continua, programa ejecuciones desde un servicio confiable y envía fallos a un canal atendido. Si usas GitHub Actions con schedule, la frecuencia mínima documentada es cada cinco minutos; un workflow programado puede retrasarse, así que no lo trates como garantía de respuesta inmediata. Evita saturar una ruta costosa: el monitor también genera tráfico.
Evita falsos verdes y falsos sustos
Un 200 solo demuestra que el contrato elegido respondió en ese momento. No cubre pagos, email, usuarios de otras regiones ni errores que aparecen bajo carga. Añade comprobaciones distintas solo cuando representen decisiones importantes, y mantén cada una pequeña. Para reducir alertas transitorias, puedes confirmar un segundo fallo antes de escalar, pero registra el primero y nunca escondas una caída prolongada. Si la ruta devuelve datos de negocio, valida un campo concreto, no solo ok.
El monitor debe vivir fuera de la misma infraestructura que observa: si la plataforma cae por completo, un cron dentro de la app puede caer con ella. Documenta quién recibe alertas y cuál es el primer paso de recuperación. Una comprobación automática sin dueño no ayuda al usuario.