Tu app ya usa gemini-3.8-flash. Cambias la cadena por gemini-4-hydrogen, despliegas y descubres que algunas llamadas fallan, otras cuestan más por el razonamiento y tu caché explícita dejó de funcionar. Esa es la migración que conviene evitar. La lista oficial de Google, publicada con Hydrogen el 12 de noviembre de 2026, permite hacer un cambio pequeño, medible y reversible.
Esta guía es para desarrolladores que ya envían solicitudes a Gemini API. Si solo usas la aplicación Gemini, no necesitas modificar código. Hydrogen está disponible en AI Studio y API, con nivel gratuito limitado y tarifa de pago; revisa tu cuota antes de iniciar pruebas.
1. Guarda un caso de referencia antes de tocar producción
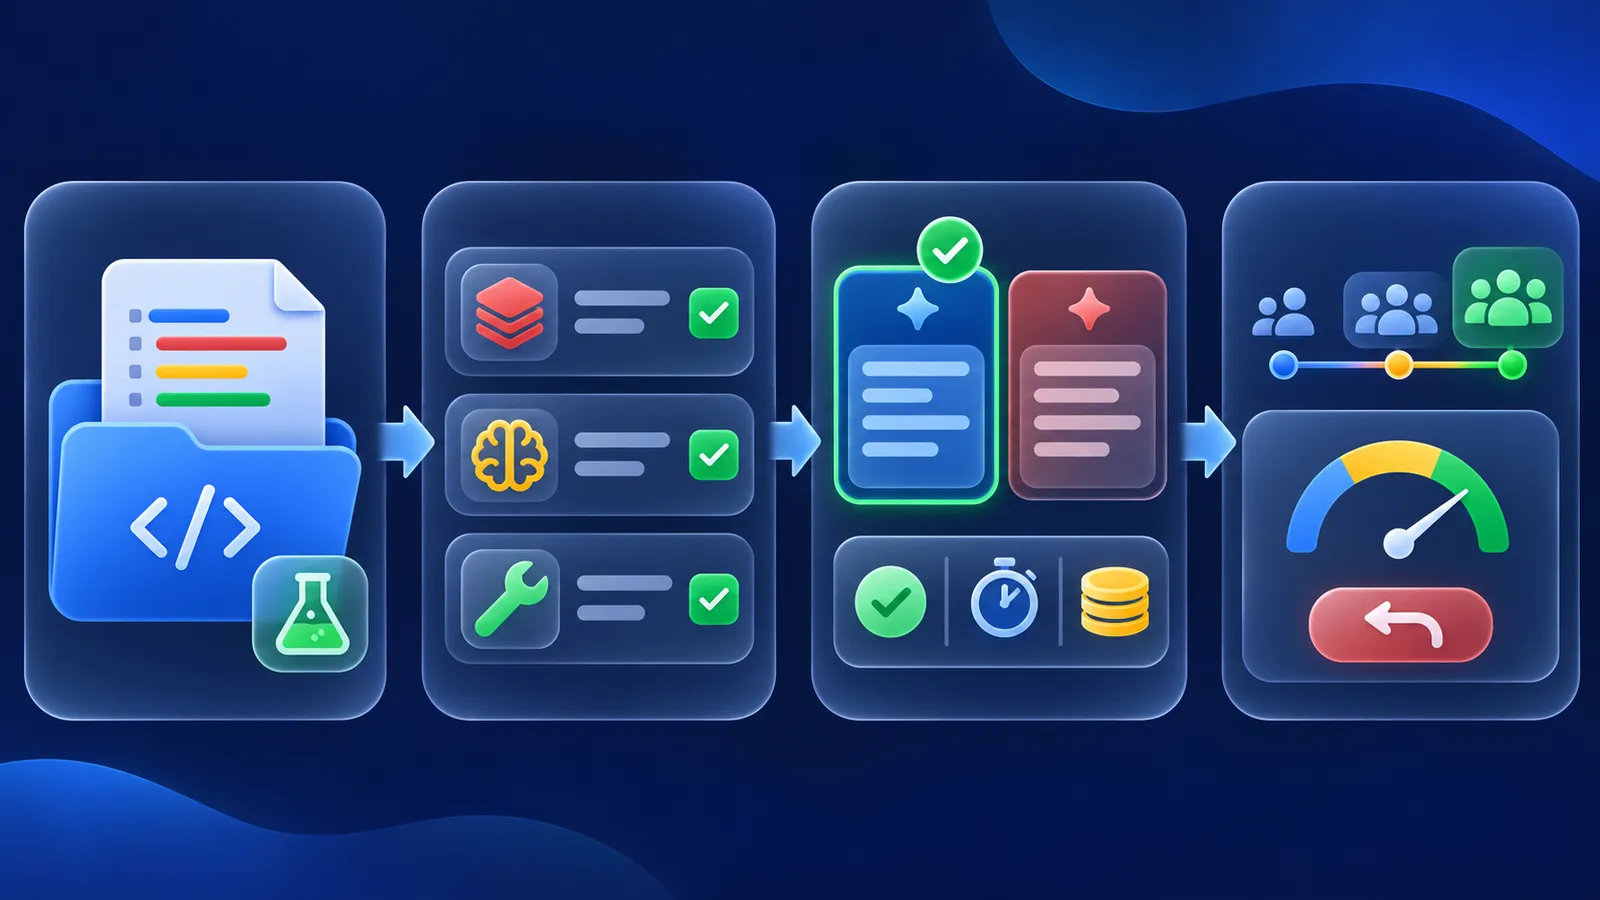
Elige tres entradas reales: una simple, una con herramientas y otra larga. Guarda la solicitud, el resultado que consideras correcto, latencia, tokens y costo aproximado con Flash. Si el agente modifica archivos, conserva también el repositorio de prueba y una comprobación ejecutable. Un cambio de modelo que suena mejor en una conversación aislada puede fallar en la parte decisiva del flujo.
2. Cambia el ID y revisa parámetros incompatibles
Usa gemini-4-hydrogen en Gemini API. En Vercel AI Gateway el identificador es google/gemini-4-hydrogen; no mezcles los dos formatos. Google indica estos ajustes al pasar desde Gemini 3.8 Flash:
- Razonamiento: Hydrogen usa
highpor defecto, nomedium. Admitelow,medium,highyxhigh;minimalproduce error. Comparamediumyhighcon el mismo conjunto de casos. - Caché: elimina
cached_contenty cualquier llamada a caché explícita. Hydrogen no la admite. La caché implícita funciona por defecto en prompts de al menos 4.096 tokens, con descuento en aciertos; no supongas que cada solicitud obtiene ese descuento. - Muestreo: quita
temperature,top_pytop_k; el servidor ignora valores personalizados. - Ventana y salida: entrada, pensamiento y salida comparten 1.048.576 tokens. Una respuesta síncrona sigue limitada a 65.536 tokens por tramo. Quita límites antiguos demasiado bajos solo si tu caso necesita espacio y pon un techo de gasto.
- Herramientas: declara funciones nativas o un esquema de salida estructurada. No pidas llamadas de herramienta como texto JSON improvisado.
3. Haz una llamada mínima y comprueba la respuesta
Con una clave de Gemini API guardada en la variable GEMINI_API_KEY, este ejemplo usa la Interactions API que figura en la documentación oficial. El texto del caso es deliberadamente pequeño: verifica acceso y estructura, no calidad de un agente completo.
curl -sS https://generativelanguage.googleapis.com/v1beta/interactions \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Resume en tres pasos cómo revisar un pull request."
  }'
Ejecuta esta llamada primero en un entorno de prueba. Si no tienes clave, puedes revisar el cuerpo JSON localmente, pero eso no verifica acceso ni comportamiento del modelo. No pegues la clave en un repositorio o captura.
4. Protege el estado de los agentes
Las conversaciones con herramientas requieren conservar correctamente los turnos. En Interactions API, utiliza previous_interaction_id para continuar una sesión. Si gestionas historial con generateContent, conserva los turnos y las thought signatures sin modificarlas. No copies una firma entre llamadas de función paralelas. Google documenta que omitir herramientas declaradas o reconstruir mal el estado puede producir errores como MALFORMED_FUNCTION_CALL.
5. Decide con costo y errores reales
Hydrogen cuesta, según Google, US$1,50 por millón de tokens de entrada y US$7,50 por millón de salida, incluidos los tokens de pensamiento. El nivel gratuito está limitado. Para cada caso registra: tarea completada, errores, cambios humanos, tiempo, tokens de entrada/salida y costo. Repite con Flash y con Hydrogen en medium y high. Elige el nivel más barato que supere tu criterio de calidad. Usa xhigh solo en problemas que justifiquen más latencia y tokens.
Si necesitas más de 65.536 tokens de salida, Google exige ejecución background=true con max_output_tokens superior al límite, o continuación del cliente. Eso es un flujo diferente: no actives salidas enormes en producción para resolver una respuesta truncada sin investigar la causa. Despliega la migración de forma gradual y conserva la configuración anterior para revertir si bajan la calidad o el éxito de herramientas.
Alcance de esta prueba: se verificó la estructura del ejemplo y la lista de cambios contra la documentación oficial; no se hizo una llamada autenticada a Gemini ni se midió una mejora propia.
Fuentes: guía y checklist de Google, changelog de Gemini API, ID de AI Gateway en Vercel.