Tu entrevista dice «el plan cuesta quince dólares» y la transcripción escribe «50 dólares». Solo cambió una palabra, pero publicar esa cita puede cambiar la promesa de tu producto. Si conviertes audio en artículos, subtítulos o clips, la pregunta no es si el texto parece correcto: es qué partes revisas antes de poner tu nombre debajo. Esta guía propone un control de diez minutos, una medida reproducible y una regla para detectar errores que una cifra global puede ocultar.
Primero, conserva el audio y el fragmento original
Puedes empezar con el transcriptor gratuito de SoyJB: acepta audio en varios formatos y permite descargar TXT o SRT. Su modo predeterminado procesa en el navegador; el modo servidor opcional pasa por un proveedor externo. Elige según la sensibilidad del archivo. Si usas otra herramienta, el control que sigue es el mismo. Guarda el audio original, la transcripción sin corregir y la fecha de generación. Sin esos tres elementos, una corrección posterior puede parecer una cita original.
Separa la tarea en dos salidas. Un TXT sirve para revisar contenido y citas. Un SRT además necesita revisar el tiempo de entrada y salida: una palabra correcta que aparece en el momento equivocado también falla como subtítulo. No borres la versión inicial; trabaja en una copia y conserva qué cambiaste.
Una muestra humana antes de confiar en el porcentaje
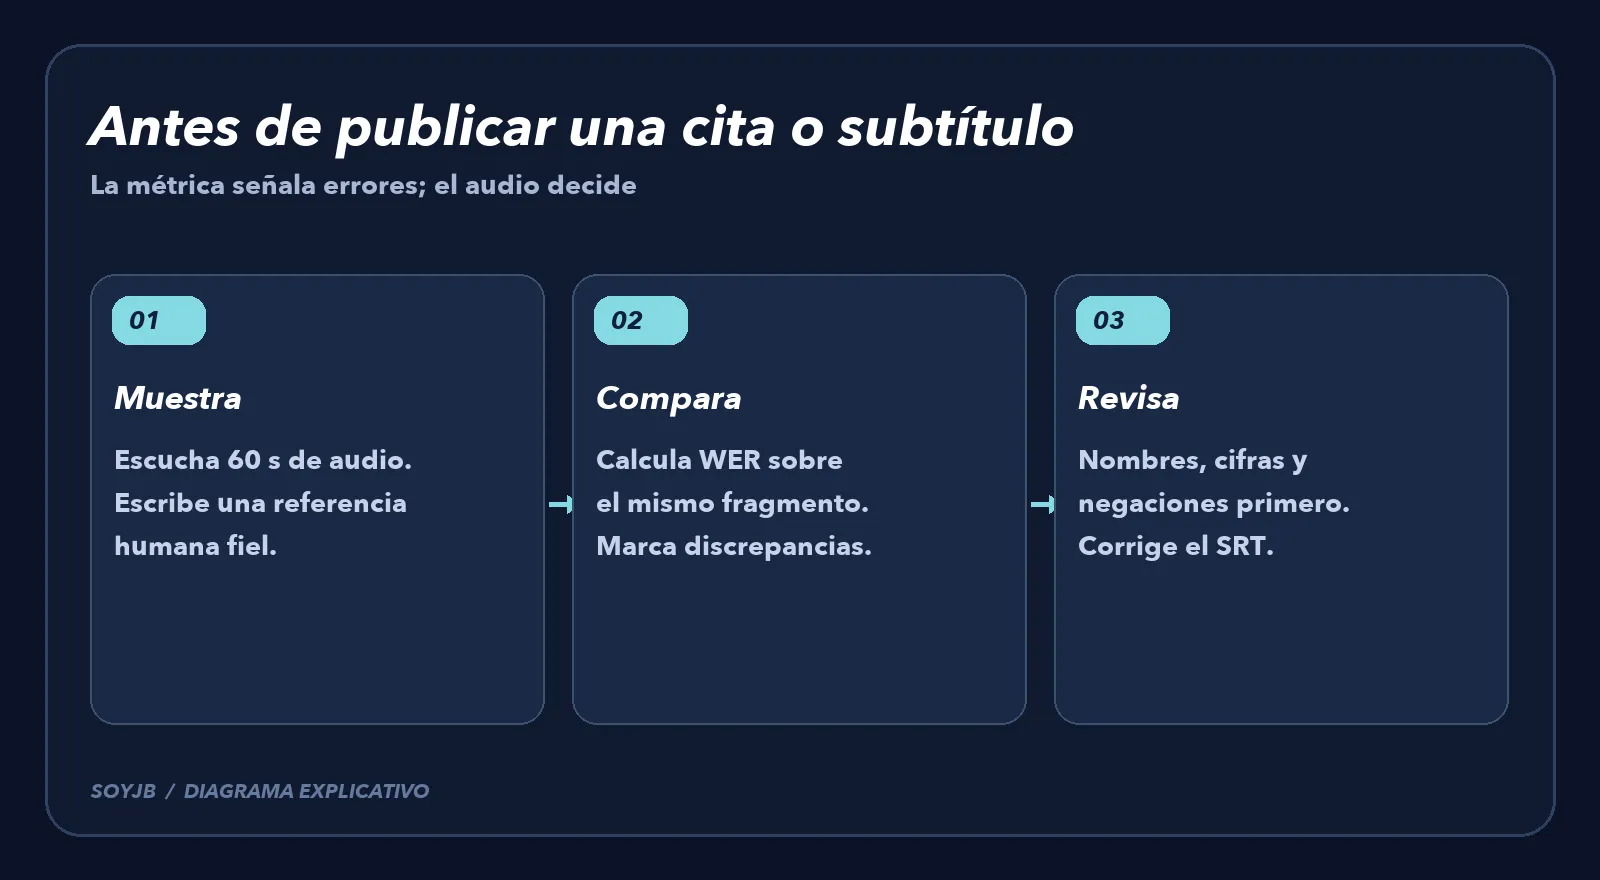
Elige 60 segundos que sí se parezcan al audio que vas a publicar: si hay dos voces, ruido o un acento particular, incluye ese tramo. Escúchalo y escribe una referencia humana palabra por palabra. Luego copia solo el mismo intervalo del texto automático. Comparar tramos diferentes da un número sin sentido. Repite con una segunda muestra si la grabación cambia de hablante o de calidad; una muestra breve no demuestra la precisión de toda la hora.
La explicación de Hugging Face sobre WER cuenta sustituciones, palabras omitidas y palabras añadidas, y divide esos errores entre las palabras de la referencia. Puedes reproducir la cuenta con Python estándar, sin instalar paquetes. Copia el siguiente archivo como transcript_qc.py y prepara dos archivos UTF-8: reference.txt con lo que oíste y model.txt con la salida automática del mismo fragmento.
"""Small, dependency-free word-error-rate check for a human reference and transcript."""
import re
import sys
from pathlib import Path


def words(text):
    return re.findall(r"\b\w+\b", text.casefold())


def word_error_rate(reference, predicted):
    a, b = words(reference), words(predicted)
    if not a:
        raise ValueError("The human reference is empty")
    previous = list(range(len(b) + 1))
    for i, expected in enumerate(a, 1):
        current = [i]
        for j, actual in enumerate(b, 1):
            current.append(min(
                current[-1] + 1,           # insertion
                previous[j] + 1,           # deletion
                previous[j - 1] + (expected != actual),  # substitution
            ))
        previous = current
    return previous[-1] / len(a)


if __name__ == "__main__":
    if len(sys.argv) != 3:
        raise SystemExit("Usage: python3 transcript_qc.py reference.txt model.txt")
    reference = Path(sys.argv[1]).read_text(encoding="utf-8")
    predicted = Path(sys.argv[2]).read_text(encoding="utf-8")
    print(f"WER: {word_error_rate(reference, predicted):.1%}")
Ejecuta python3 transcript_qc.py reference.txt model.txt. Con «El lanzamiento cuesta quince dólares» frente a «El lanzamiento cuesta 50 dólares», el programa devuelve WER: 20.0%: una sustitución entre cinco palabras. Probé este código localmente con ese caso, coincidencia exacta, una inserción y una omisión. No probé un modelo de transcripción con audio real para este artículo.
Lo que la métrica no puede decidir
Un 20% no te dice si el error fue «el» o el precio de venta. Antes de citar o publicar subtítulos, escucha de nuevo cada frase con cifras, fechas, nombres propios, unidades, negaciones y promesas. Marca una palabra como «inaudible» si no puedes resolverla; no pidas a un modelo que invente el dato más probable. Si cambias la formulación para que se lea mejor, preséntala como paráfrasis, no como cita textual. También comprueba quién dijo cada frase cuando hay varias voces: WER no valida atribución de hablante.
Para SRT, abre el video y reproduce tres puntos: inicio, medio y final. Revisa que el texto aparezca cuando se pronuncia, que no tape información esencial y que la última palabra no quede cortada. Una transcripción correcta con marcas de tiempo incorrectas puede confundir tanto como una palabra equivocada.
Una regla de publicación razonable
Usa WER para decidir dónde investigar, no como sello automático de calidad. Si la muestra tiene errores, revisa más audio o cambia de herramienta antes de escalar la producción. Aunque salga bien, verifica manualmente todas las frases de mayor impacto. Si no puedes escuchar el audio o no tienes permiso para publicar la voz o la cita, no conviertas el texto automático en una afirmación atribuida. El ahorro de tiempo real está en automatizar el primer borrador y concentrar la revisión humana donde un error cambia el significado.