Un modelo nuevo obtiene una puntuación espectacular en un benchmark público. Tu producto, sin embargo, necesita decidir si un mensaje recibido pide soporte, una venta o es spam. La pregunta útil no es cuál ganó una tabla general, sino cuál resuelve tus mensajes con menos errores que afecten al cliente. Puedes empezar con veinte casos propios, una respuesta de referencia por caso y un evaluador local sencillo.
La guía de evaluación de OpenAI recomienda definir el objetivo antes de medir, combinar casos reales con ejemplos de expertos y evitar métricas demasiado genéricas. Aquí aplicamos ese principio sin depender de la plataforma de evaluaciones de ningún proveedor. El ejemplo de abajo es una clasificación de tres etiquetas. No hay llamadas a modelos en este artículo: el script mide respuestas que tú obtengas y pegues en un CSV.
1. Forma una muestra que se parezca a tu producto
Elige veinte mensajes recientes, anonimizados y con permiso de uso interno. Incluye casos fáciles y difíciles: una consulta de precio, un reporte de error, una queja que también menciona comprar y un mensaje promocional disfrazado de consulta. No copies nombres, correos ni datos sensibles al archivo de prueba. Si tus casos de producción son 70 % soporte, 20 % ventas y 10 % spam, conserva una mezcla parecida o reporta claramente que la muestra fue balanceada de forma artificial. Veinte ejemplos sirven para detectar fallos obvios, no para afirmar superioridad estadística general.
Escribe la respuesta correcta antes de ver los resultados de los modelos. En caso de duda, define una regla: por ejemplo, “si pide resolver un problema con una compra existente, soporte; si pregunta por contratar, ventas”. Si dos personas no coinciden en una etiqueta, aclara la rúbrica y vuelve a etiquetar. Un modelo no puede ser evaluado limpiamente contra una verdad de referencia que cambia según quién la lee.
2. Ejecuta exactamente la misma tarea
Usa el mismo texto de instrucción, las mismas etiquetas permitidas, el mismo conjunto de mensajes y ajustes de salida lo más comparables posible para A y B. Solicita una sola etiqueta por caso; registra modelo y versión, fecha, temperatura, límite de tokens, costo y latencia si están disponibles. No cambies el prompt de B después de ver sus errores sin repetir también A. Si un modelo devuelve una explicación además de la etiqueta, normaliza la respuesta manualmente, pero guarda el original para revisar el fallo.
Este CSV muestra cuatro filas ficticias para que puedas comprobar el método. Sustitúyelas por tus veinte casos reales y sus respuestas. Las etiquetas están en inglés porque el script usa sales, support y spam; la tarea puede recibir mensajes en español.
case_id,expected,model_a,model_b
ex-01,sales,sales,sales
ex-02,support,support,sales
ex-03,spam,spam,spam
ex-04,support,sales,sales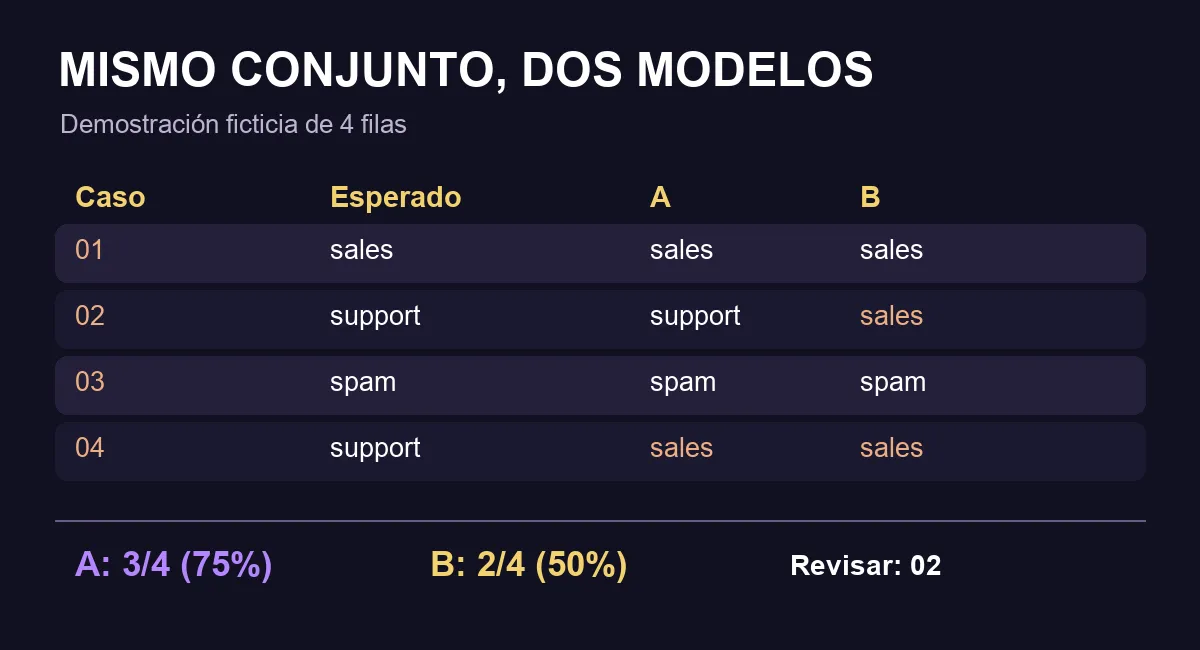
3. Calcula aciertos y desacuerdos localmente
Guarda el CSV como results.csv y este archivo como compare_models.py. Ejecuta python3 compare_models.py results.csv. No requiere paquetes externos:
import csv
import sys
from collections import Counter

LABELS = {'sales', 'support', 'spam'}
REQUIRED = {'case_id', 'expected', 'model_a', 'model_b'}

def main(path):
    with open(path, newline='', encoding='utf-8') as handle:
        reader = csv.DictReader(handle)
        if not REQUIRED.issubset(reader.fieldnames or []):
            raise ValueError(f'Missing columns: {sorted(REQUIRED - set(reader.fieldnames or []))}')
        rows = list(reader)
    if not rows:
        raise ValueError('No test cases')
    ids = [row['case_id'].strip() for row in rows]
    if any(not case_id for case_id in ids) or len(ids) != len(set(ids)):
        raise ValueError('Empty or duplicate case_id')
    for row in rows:
        for field in ('expected', 'model_a', 'model_b'):
            row[field] = row[field].strip().lower()
            if row[field] not in LABELS:
                raise ValueError(f"{row['case_id']}: invalid {field}={row[field]!r}")
    for model in ('model_a', 'model_b'):
        correct = sum(row[model] == row['expected'] for row in rows)
        by_label = Counter(row['expected'] for row in rows)
        print(f'{model}: {correct}/{len(rows)} correct ({correct/len(rows):.1%})')
        print('  gold labels:', ', '.join(f'{label}={by_label[label]}' for label in sorted(LABELS)))
    disagreements = [row['case_id'] for row in rows if row['model_a'] != row['model_b']]
    print('disagreements for review:', ', '.join(disagreements) or 'none')

if __name__ == '__main__':
    if len(sys.argv) != 2:
        raise SystemExit('Usage: python3 compare_models.py results.csv')
    main(sys.argv[1])
Probamos el script con el CSV ficticio: A dio 3/4 aciertos (75 %), B 2/4 (50 %) y el caso ex-02 apareció como desacuerdo. El programa comprueba columnas, IDs duplicados y etiquetas inválidas. El resultado no demuestra que A sea mejor en tu negocio; solo confirma la aritmética de este ejemplo. Con veinte casos, cada error cambia el porcentaje cinco puntos, por lo que conviene mirar los casos individuales antes de decidir.
4. Decide por el error que importa
Un falso “ventas” para alguien que necesita soporte puede ser más costoso que clasificar un mensaje comercial como soporte. Revisa una tabla de errores por categoría y marca los casos graves. Considera un modelo ganador solo si mantiene calidad suficiente en la categoría crítica, cabe en tu presupuesto y responde a tiempo para el flujo. Si quedan cerca, agrega más casos reales, haz una segunda pasada con los mismos inputs y observa la estabilidad. Guarda el CSV y la versión del prompt para detectar regresiones al actualizar el modelo.
Este evaluador mide coincidencia exacta de etiquetas, no calidad de redacción, seguridad, privacidad ni resultados comerciales. Para generación abierta, una rúbrica humana con ejemplos de buenas y malas respuestas es más apropiada. En cualquier formato, compara el desempeño sobre el trabajo que realmente vas a lanzar, no sobre un titular de benchmark.
Fuente: OpenAI, Evaluation best practices. El CSV, el código y el diagrama son ejemplos propios de SoyJB; no representan pruebas pagadas de modelos.