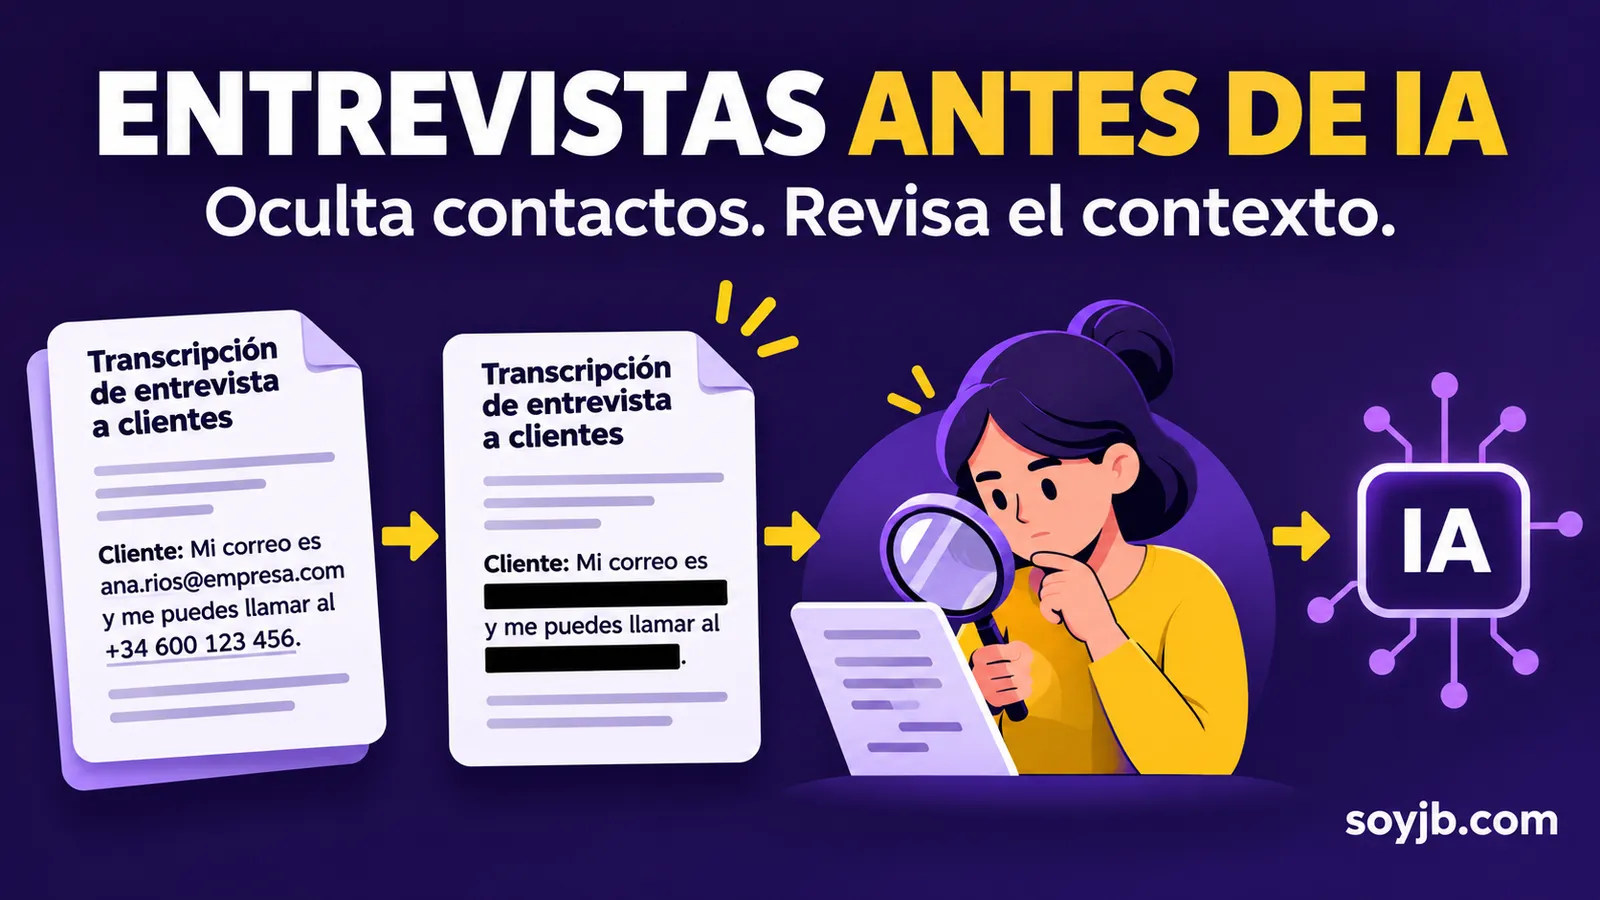
Vas a pedirle a un asistente de IA que resuma diez entrevistas de clientes. Una transcripción contiene el correo de una entrevistada, su teléfono y la dirección de su negocio. Si la subes tal cual, esos datos ya salieron de tu flujo local. Antes de compartirla, puedes hacer una primera limpieza reproducible con Python y después revisar el texto a mano. Este tutorial usa datos ficticios y no promete anonimización completa.
Decisión antes de tocar el archivo
Define qué necesita el análisis. Para detectar objeciones de compra, quizá basta con el sector, el problema, la cita y un identificador como «Participante 1». Conserva el archivo original en un lugar autorizado; crea otro archivo para revisar y subir. Si la entrevista incluye salud, finanzas, secretos comerciales o datos de terceros, aplica las reglas de tu organización y considera no enviarla a un servicio externo. OWASP identifica la información personal y confidencial como un riesgo de divulgación en aplicaciones con modelos de lenguaje.
Un filtro local que puedes copiar
Guarda esto como redact_interview.py. Usa solo la biblioteca estándar de Python 3: re.subn reemplaza coincidencias y devuelve cuántas encontró. El programa se niega a sobrescribir el archivo de entrada o una salida existente, y muestra los conteos sin imprimir el contenido sensible.
import argparse
import re
from pathlib import Path

EMAIL = re.compile(r"(?<![\w.+-])[\w.+-]+@[\w.-]+\.[A-Za-z]{2,}(?![\w.-])")
PHONE = re.compile(
    r"(?<!\w)(?:\+?\d{1,3}[\s.-]?)?(?:\(?\d{3}\)?[\s.-]?)\d{3}[\s.-]?\d{4}(?!\w)"
)

def mask(text: str) -> tuple[str, int, int]:
    text, emails = EMAIL.subn("[EMAIL]", text)
    text, phones = PHONE.subn("[PHONE]", text)
    return text, emails, phones

parser = argparse.ArgumentParser()
parser.add_argument("input", type=Path)
parser.add_argument("output", type=Path)
args = parser.parse_args()
if args.input.resolve() == args.output.resolve() or args.output.exists():
    parser.error("elige una ruta de salida nueva")
cleaned, emails, phones = mask(args.input.read_text(encoding="utf-8"))
with args.output.open("x", encoding="utf-8") as file:
    file.write(cleaned)
print(f"Ocultados: {emails} correos y {phones} teléfonos. Revisa a mano.")
Ejecuta python3 redact_interview.py entrevista.txt entrevista-revisar.txt. No uses el nombre «anonimizado» todavía: el resultado requiere revisión humana. Si quieres descargar exactamente el archivo probado para este artículo, copia el bloque anterior; la variante de trabajo local de SoyJB también conserva la misma función mask y las mismas comprobaciones de no sobrescritura.
Qué probé y qué observé
Ejecuté el programa localmente con una transcripción ficticia: ana@example.com, jo.smith+test@example.co.uk, +1 (787) 555-0199 y 415-555-0100. Informó «2 correos y 2 teléfonos»; ambos tipos quedaron como marcadores en la salida y el archivo original conservó sus valores. También dejé deliberadamente «Ana» y «Calle Sol 12»: el filtro no los reconoce. Es una prueba del código con esos formatos, no una validación universal de todos los teléfonos ni una prueba dentro de Gemini, Claude o ChatGPT.
La revisión manual que no debes saltar
- Abre solo
entrevista-revisar.txt. Busca nombres, direcciones, empresas pequeñas, URLs privadas, cuentas, importes, diagnósticos, fechas singulares y frases que permitan reconocer a alguien. - Cambia cada persona por un identificador estable, por ejemplo «Participante 1», y generaliza detalles que no aportan a la pregunta. Revisa también metadatos, nombres de archivo y documentos adjuntos.
- Haz una segunda lectura como si fueras una persona que conoce al entrevistado. Si todavía puedes deducir quién es por el contexto, elimina o agrupa más detalles.
- Confirma los permisos y ajustes de retención del servicio que usarás. No asumas que desactivar entrenamiento equivale a borrado inmediato o a privacidad absoluta.
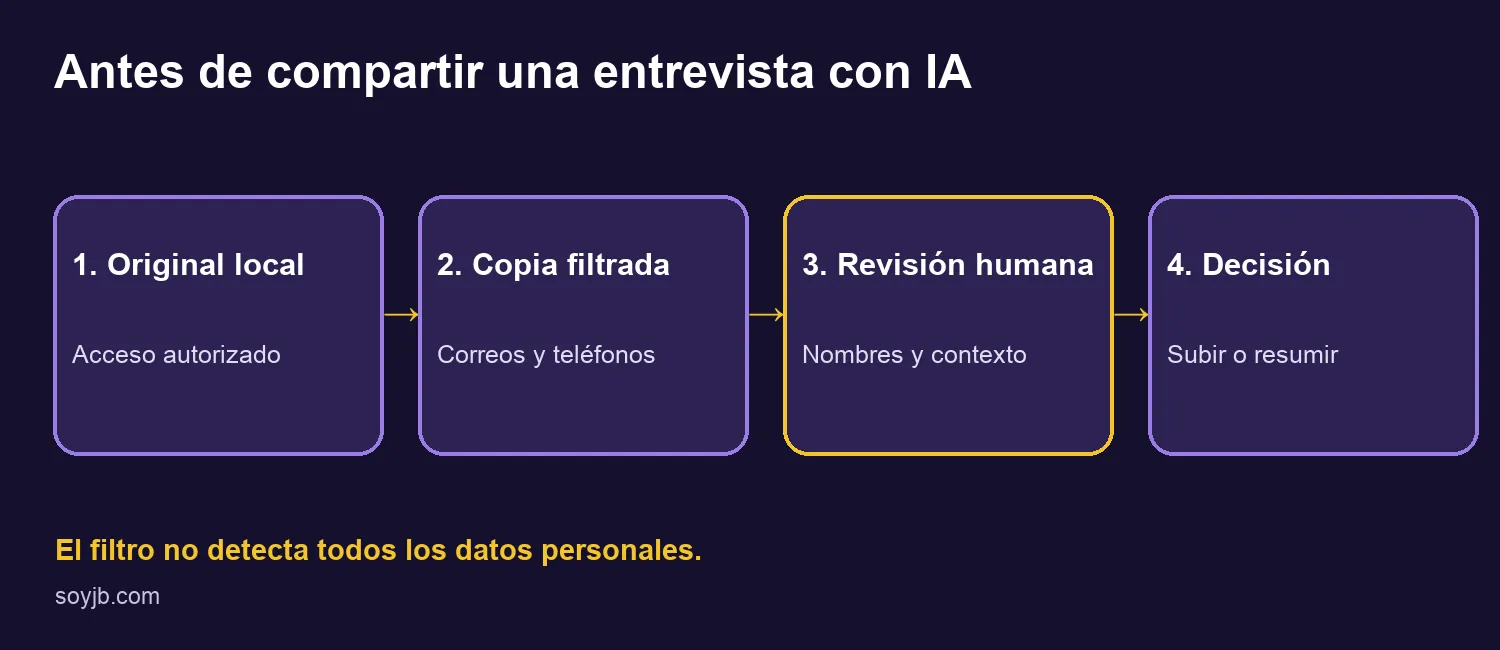
En la imagen siguiente está el flujo de decisión: original local, copia filtrada, revisión humana y solo entonces análisis de IA. Si no puedes completar la revisión o el servicio no permite el tratamiento previsto, trabaja con notas agregadas en lugar de la transcripción.
Prompt para analizar sin pedir identidades
Analiza este texto de entrevista para identificar problemas,
objeciones y frases representativas. No intentes inferir ni
reconstruir identidades. Separa evidencia textual de hipótesis.
Devuelve una tabla con: tema, cita breve, frecuencia observada,
incertidumbre y una pregunta de seguimiento para la próxima entrevista.
El prompt orienta el análisis, pero no sustituye el control de datos previo. Tampoco garantiza que el proveedor no retenga información: revisa sus términos y controles para tu cuenta y región. En particular, los controles de historial y uso para mejorar modelos pueden diferir, como explican las páginas de ayuda de Gemini.
Cuándo sirve y cuándo no
Este flujo sirve como primera barrera para entrevistas de descubrimiento de un MVP cuando tienes autorización para procesarlas y necesitas resumir patrones. Si la pregunta puede resolverse con conteos y notas ya agregadas, evita subir la transcripción. La expresión regular puede omitir teléfonos internacionales, extensiones, números escritos con palabras y correos mal formados; también puede marcar números que no son teléfonos. Ningún marcador elimina nombres o pistas indirectas. Trata la salida como borrador para revisión, no como certificado de anonimato.