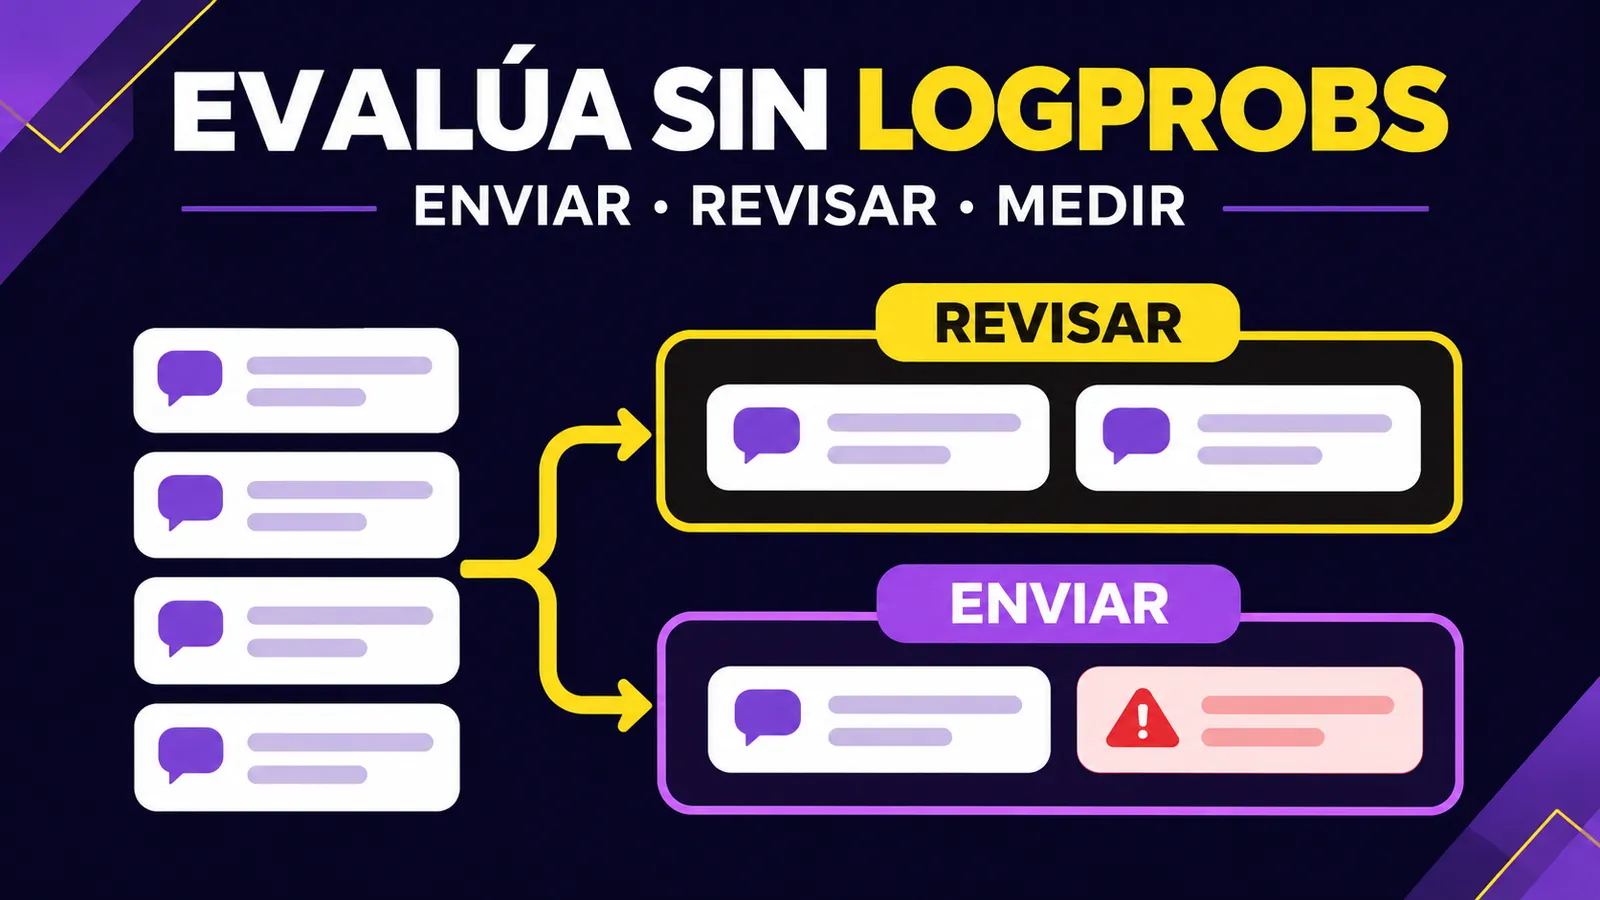
Si tu asistente de IA decide qué solicitudes responder automáticamente y cuáles enviar a revisión humana, una probabilidad por token puede parecer la forma más fácil de medir confianza. Pero no necesitas logprobs para evaluar si la decisión es segura. Necesitas ejemplos etiquetados, una regla de salida clara y contar los errores que más importan.
Esta guía propone una prueba local y reproducible para una política binaria: send significa enviar la respuesta sin revisión; review significa que una persona la compruebe. El ejemplo es sintético. No es una prueba de Gemini, de otro modelo ni de un sistema en producción.
Primero, define el error que no puedes aceptar
Imagina un asistente que contesta preguntas de clientes sobre facturación. Un caso safe tiene una respuesta verificable y autorizada. Un caso unsafe contiene una afirmación incorrecta, un dato privado o una solicitud que requiere intervención humana. Tu evaluador revisa cada caso y asigna esa etiqueta antes de mirar la decisión del sistema.
Si un caso unsafe sale como send, tienes un envío peligroso. Si un caso safe va a review, gastas tiempo de revisión, pero no cometes ese error. Esta asimetría debe guiar la política: en facturación, la calidad de los envíos automáticos importa más que maximizar la automatización.
Prepara un CSV pequeño y ejecuta el cálculo
Guarda este ejemplo como ejemplos.csv. Los ocho registros son datos inventados para explicar el método; sustitúyelos por casos reales etiquetados por tu equipo.
id,gold,decision
1,safe,send
2,safe,send
3,unsafe,review
4,unsafe,send
5,safe,review
6,unsafe,review
7,safe,send
8,unsafe,review
Guarda el bloque siguiente como evaluar.py. No llama a ninguna API.
import csv
import sys

def ratio(a, b):
    return "n/a" if b == 0 else f"{a / b:.1%}"

with open(sys.argv[1], newline="", encoding="utf-8") as f:
    rows = list(csv.DictReader(f))

if not rows:
    raise ValueError("CSV vacío")
if len({r["id"] for r in rows}) != len(rows):
    raise ValueError("Hay IDs duplicados")
for r in rows:
    if r["gold"] not in {"safe", "unsafe"} or r["decision"] not in {"send", "review"}:
        raise ValueError(f"Etiqueta inválida: {r['id']}")

sent = [r for r in rows if r["decision"] == "send"]
unsafe = [r for r in rows if r["gold"] == "unsafe"]
bad_sent = sum(r["gold"] == "unsafe" for r in sent)
caught = sum(r["decision"] == "review" for r in unsafe)

print("Ejemplos:", len(rows))
print("Envío automático:", len(sent), ratio(len(sent), len(rows)))
print("Error entre envíos:", bad_sent, "/", len(sent), ratio(bad_sent, len(sent)))
print("Casos inseguros revisados:", caught, "/", len(unsafe), ratio(caught, len(unsafe)))
Ejecuta python3 evaluar.py ejemplos.csv. En este conjunto inventado hay 8 casos, 4 envíos automáticos (50 %), 1 envío unsafe entre los 4 envíos (25 %) y 3 de los 4 casos unsafe enviados a revisión (75 %). Corrí el cálculo localmente con Python 3 y obtuve esos valores. El 25 % aquí no estima el riesgo de tu producto: ocho ejemplos no bastan.
Cómo convertirlo en una evaluación útil
- Escribe la política antes de medir. Define qué cuenta como safe y quién puede aprobarlo. Incluye respuestas con datos privados, preguntas ambiguas y consultas fuera del dominio.
- Etiqueta casos reales. Usa muestras recientes y casos difíciles; elimina identificadores personales o usa un entorno autorizado para revisarlos. Haz que dos revisores comparen los desacuerdos.
- Congela un conjunto de prueba. Separa ejemplos para ajustar el prompt de otros para medir la versión final. Si optimizas sobre todos, la cifra deja de representar casos nuevos.
- Guarda la decisión observable. Registra el ID, la etiqueta humana, send/review, versión del prompt o modelo y fecha. No necesitas inferir la confianza interna del modelo.
- Prueba umbrales operativos. Cambia la regla que manda casos a revisión y compara dos números: error entre los envíos y cobertura de envío automático. Elige el punto que cumpla el riesgo aceptable.
- Repite después de cambios. Un nuevo modelo, prompt o fuente de datos puede alterar ambos números. Revisa también cada incidente real que el conjunto no anticipó.
Qué significan las métricas y sus límites
El «error entre envíos» es la fracción de respuestas enviadas automáticamente que eran unsafe según la etiqueta humana. «Casos inseguros revisados» indica qué parte de los casos unsafe detuvo la política. «Envío automático» muestra cuánta carga de revisión evitaste. Google explica las diferencias entre precisión y exhaustividad en su guía de clasificación; conviene mirar más de una métrica cuando los errores tienen costos distintos.
Las etiquetas humanas también pueden equivocarse, la mezcla de consultas cambia con el tiempo y una muestra pequeña da resultados inestables. Para decisiones sensibles, agrega intervalos de incertidumbre, una revisión por categoría y un proceso de escalamiento humano. No conviertas una puntuación generada por el modelo en una garantía de seguridad. Esta prueba evalúa resultados observables, aunque el proveedor no exponga logprobs.
Fuentes: Google Machine Learning Crash Course: accuracy, precision and recall. El CSV y el resultado local descritos arriba son un ejemplo creado para esta guía.